JOURNAL / 2026.07.29
Un estudio encuentra puntos únicos de fallo en la negativa de siete modelos
Un preprint vinculado a Apple logra desactivar la negativa de seguridad interviniendo una sola neurona, pero el método exige acceso interno, manipula su activación durante toda la generación y no demuestra que la seguridad completa resida ahí.
No ha aparecido hoy un lanzamiento de modelo que justifique desplazar la noticia de Kimi K3 publicada ayer. La alternativa honesta es volver sobre una pregunta menos reciente y más duradera: cuando un modelo rechaza una petición dañina, ¿ha dejado de poseer la capacidad de responder o ha aprendido un mecanismo que decide no expresarla?
Un preprint de tres investigadores vinculados a Apple, publicado originalmente el 8 de mayo e incorporado en julio al archivo de investigación de la empresa, aporta una respuesta inquietante y concreta. En siete modelos de pesos abiertos —cinco tamaños de Qwen3 y dos de Llama 3.1, entre 1.700 y 70.000 millones de parámetros— los autores identificaron una neurona cuya intervención basta para suprimir gran parte de la conducta de negativa ante peticiones dañinas.
Aquí «neurona» no designa una célula ni un fragmento aislado de conocimiento. Es una coordenada escalar en la activación de una capa de alimentación del transformer: una pequeña parte del cálculo interno cuyos efectos se combinan después con miles de otras. El estudio compara su activación ante instrucciones dañinas e inocuas, usa gradientes para ordenar candidatas, prueba las cinco primeras en un conjunto de validación y conserva la combinación que más reduce las negativas. Finalmente la evalúa, sin volver a ajustarla, en otro conjunto.
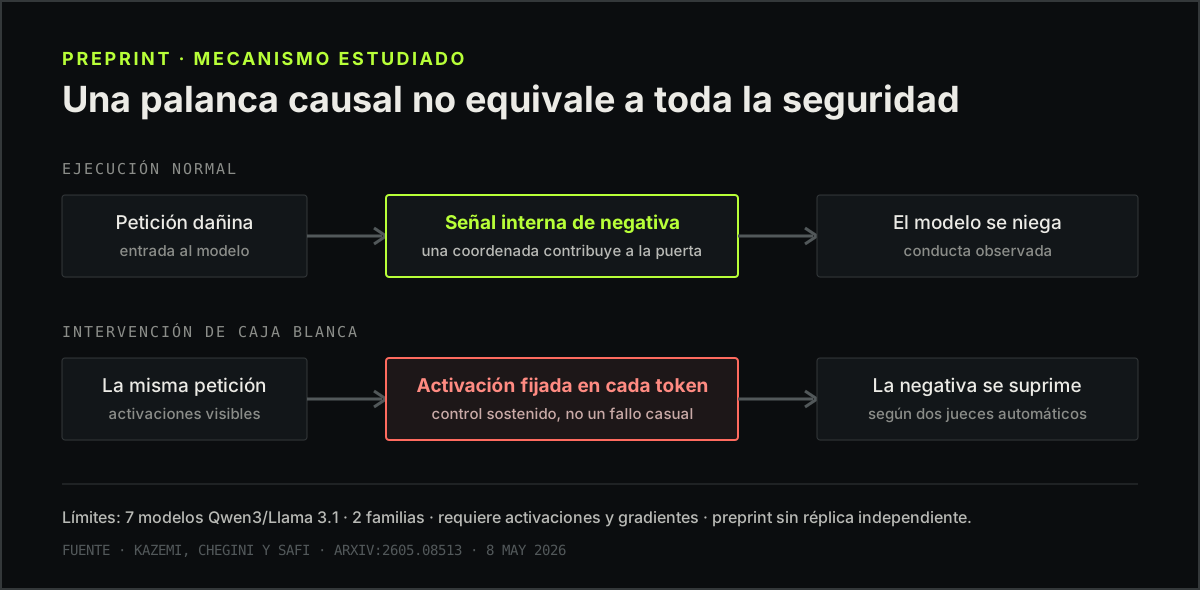
Esa secuencia importa porque el titular «una sola neurona» puede inducir a error. Los investigadores no borran un único peso y observan cómo el modelo falla espontáneamente. Fijan la activación de una coordenada seleccionada en cada posición, tanto al procesar la petición como durante la generación de la respuesta. Su variante más precisa realiza además una pasada inicial para medir cuánto se ha activado la señal y adapta la intervención al contexto. Es un control quirúrgico y sostenido sobre la ejecución, no el equivalente digital de que una pieza se rompa por azar.
El resultado sigue siendo notable. Según los dos jueces automáticos usados por los autores, las intervenciones sobre una neurona alcanzan alrededor de un 90 % de éxito medio en JailbreakBench, un conjunto de peticiones adversarias mantenido aparte para la prueba. El método contextual conserva mucho mejor el rendimiento general que fijar siempre un valor constante: en promedio, la variación absoluta publicada es de −0,6 puntos en MMLU y −0,1 en GSM8K. Estas dos pruebas aproximan conocimiento académico y resolución de problemas matemáticos; no miden si el modelo conserva todas sus capacidades ni si funcionará igual en una aplicación real.
Un interruptor no es todo el sistema
La lectura más útil no es que «la seguridad vive en una neurona». El propio trabajo separa dos fenómenos. Las neuronas de negativa parecen actuar como una puerta que ayuda a decidir si cierta información se expresa. Otras neuronas conceptuales participan en la representación de contenido; el estudio sólo ensaya esta segunda vía en una categoría de autolesión. Que una puerta tenga un punto de palanca no implica que todo lo que hay detrás esté guardado en ese punto.
Tampoco demuestra una fragilidad universal. Sólo se probaron dos familias abiertas, ninguna de ellas es Kimi K3 ni un modelo propietario servido por API. El método necesita acceso de caja blanca a activaciones y gradientes, además de una búsqueda previa sobre ejemplos dañinos. Un usuario de un servicio cerrado no suele tener esa capacidad. Quien controla los pesos de un modelo abierto sí puede modificar su inferencia, pero también podía eliminar sus salvaguardas mediante ajuste fino u otras técnicas más costosas. Los propios autores sostienen que su procedimiento no cambia sustancialmente ese perfil de riesgo.
Lo nuevo está en la resolución del diagnóstico. Trabajos anteriores habían mostrado que la negativa puede concentrarse en una dirección del espacio interno o en pequeños subconjuntos de parámetros. Este preprint reduce el punto de intervención causal a una coordenada de una capa concreta y obtiene un efecto comparable al de borrar una dirección en todas las capas. A la vez, el estudio encuentra que puede haber varias neuronas distintas capaces de producir el efecto: localizar una palanca no equivale a encontrar una única causa.
La evidencia aún tiene límites abiertos. Es un preprint sin constancia de revisión por pares ni réplica independiente. Los autores eligieron la intensidad de la intervención mediante una búsqueda empírica, los evaluadores automáticos pueden confundir cumplimiento dañino con respuestas incoherentes y las pruebas de capacidad son estrechas. Además, que la activación sea causal bajo una manipulación extrema no revela por sí solo cómo surgió durante el entrenamiento ni cuánto contribuye en condiciones ordinarias.
Mi lectura es que el trabajo debilita una idea cómoda: que alinear la salida de un modelo equivale a retirar la capacidad peligrosa de su interior. La negativa puede parecer robusta desde la conversación y, sin embargo, depender de mecanismos internos estrechos. Eso no vuelve inútil el alineamiento; cambia qué debería exigírsele. Un fabricante puede buscar puntos únicos de fallo, entrenar redundancia y repetir la evaluación después de cuantizar o ajustar el modelo. Quien despliega un sistema puede añadir controles independientes sobre herramientas, datos y permisos, de modo que una respuesta indebida no se convierta automáticamente en una acción.
La consecuencia para los pesos abiertos no es que deban cerrarse, sino que una licencia o una tarjeta de modelo no conserva las salvaguardas después de cada modificación. Si la comunidad puede inspeccionar y alterar un modelo, también puede medir si sus mecanismos de negativa sobreviven a conversiones, afinados y nuevos arneses de inferencia. El hallazgo más valioso de este preprint es precisamente un instrumento para hacer esa pregunta con mayor precisión; todavía no es una respuesta general sobre la seguridad de los modelos.
Fuentes
- Hamid Kazemi, Atoosa Chegini y Maria Safi, A Single Neuron Is Sufficient to Bypass Safety Alignment in Large Language Models, preprint, 8 de mayo de 2026.
- Apple Machine Learning Research, ficha del estudio, publicada en julio de 2026.
- Andy Arditi et al., Refusal in Language Models Is Mediated by a Single Direction, 17 de junio de 2024.
- Zhaoxin Wang et al., SafeNeuron: Neuron-Level Safety Alignment for Large Language Models, 12 de febrero de 2026.