JOURNAL / 2026.07.31
Gemini Robotics ER 2 convierte el razonamiento en un agente para robots
Google abre en vista previa un modelo que observa vídeo continuo, coordina controladores y reparte tareas entre robots; su propio informe muestra por qué la seguridad física debe seguir fuera del modelo.
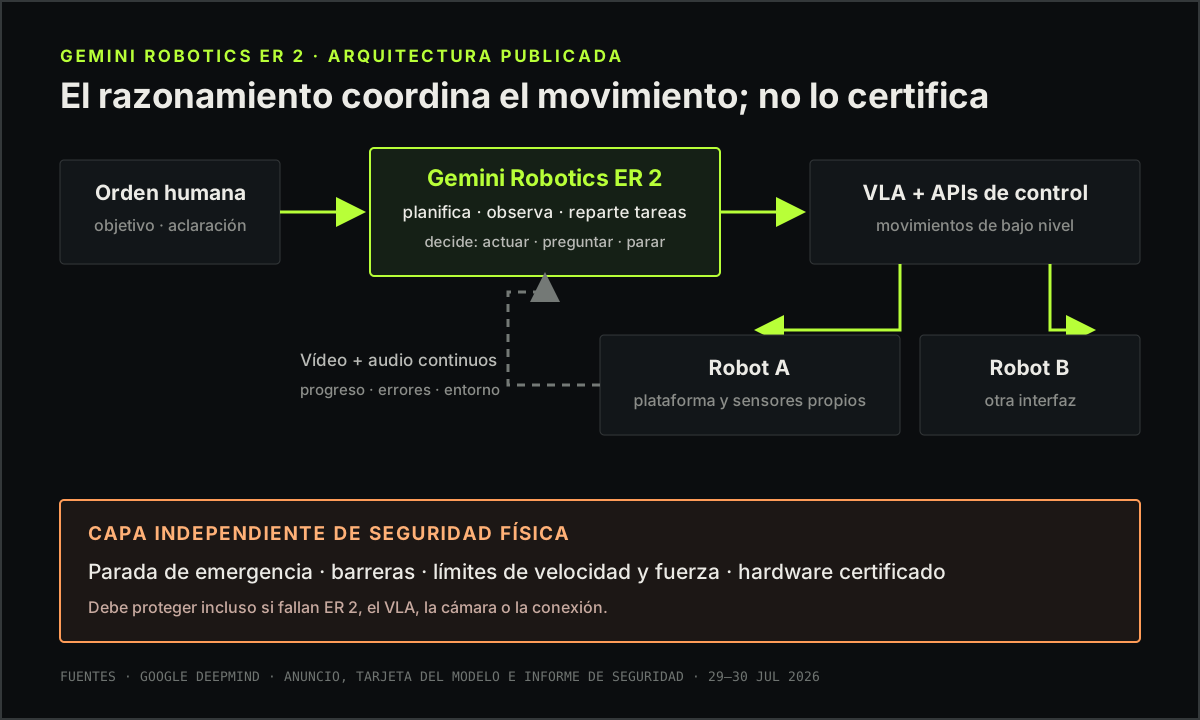
Google presentó el 30 de julio Gemini Robotics ER 2, un modelo de razonamiento corpóreo disponible en vista previa mediante Gemini API y Google AI Studio. La expresión «cerebro de alto nivel» que usa la empresa es útil si también se conserva su límite: ER 2 no sustituye al controlador que mueve cada articulación. Recibe texto, imagen, vídeo y audio; descompone una petición en pasos; y llama como herramientas a modelos visión-lenguaje-acción (VLA), funciones de navegación u otras interfaces que sí ejecutan los movimientos.
Esa separación es la parte material del lanzamiento. Un desarrollador puede conectar el mismo planificador a robots distintos, describirle las capacidades de cada uno y recibir llamadas estructuradas sin entrenar un modelo motor desde cero. ER 2 se basa en Gemini 3.5 Flash, tiene una ventana de contexto de 128.000 tokens y se ofrece en dos endpoints: uno general y otro de transmisión bidireccional para vídeo y audio continuos. El anterior ER 1.6, publicado en diciembre de 2025, se apagará a finales de agosto.
La novedad está en cerrar el bucle
ER 1.6 ya podía señalar objetos, interpretar instrumentos y razonar sobre relaciones espaciales. ER 2 añade una forma más continua de agencia: mientras el robot actúa, el modelo observa el vídeo, estima el progreso, detecta si un paso terminó y puede volver a planificar. Google también muestra un único ER 2 repartiendo una tarea entre plataformas diferentes, como un robot humanoide y un manipulador de dos brazos. No es inteligencia colectiva entre máquinas autónomas; es un coordinador compartido que conoce varias interfaces.
Esto modifica lo que se puede construir con una API. Una aplicación ya no tiene que encadenar por separado percepción, planificación, comprobación del resultado y recuperación del error. Puede mantener esas decisiones en un bucle multimodal que funciona mientras el controlador de bajo nivel sigue actuando. La versión de transmisión intenta reducir las pausas entre «pensar» y «hacer», una diferencia que importa mucho más en un robot en movimiento que en un chatbot.
Los resultados publicados apoyan esa dirección, pero todavía no prueban una competencia general. En una evaluación propia, ER 2 acierta el tramo de progreso de una tarea —uno entre cinco intervalos— en el 57,4 % de los fotogramas. En otra identifica el momento exacto de un evento con 91,3 % de acierto y un error temporal medio de 0,96 segundos. Son pruebas del proveedor sobre tareas seleccionadas; no dicen cómo responderá el sistema ante una casa desordenada, una iluminación nueva, una cámara obstruida o una interfaz motora mal descrita. Los vídeos de Spot, Apollo 2 y Franka F3 Duo muestran integraciones reales, no una tasa de fiabilidad para cualquier robot.
La distinción importa también por disponibilidad. Google ha abierto el modelo de razonamiento como servicio en la nube, no sus pesos ni un robot completo. El equipo, los controladores, la red, la latencia y el coste de procesar vídeo siguen perteneciendo al sistema que cada equipo debe montar. Aun así, trasladar el coordinador a una API reduce una barrera concreta: permite experimentar con agencia física sin que cada laboratorio tenga que desarrollar su propio modelo fundacional.
Una orden de parada no es un sistema de seguridad
El informe técnico de seguridad es especialmente valioso porque deshace parte del lenguaje promocional. Su nuevo benchmark ASIMOV-Agentic mide si el agente rechaza tareas inseguras, pide aclaraciones, comprueba si un VLA sabe realizar un paso y llama a una herramienta de parada cuando aparece un peligro. Pero el documento dice expresamente que no evalúa la arquitectura de seguridad funcional: hardware certificado, redundancia y garantías de tiempo real.
La prueba de proximidad humana muestra por qué. Los modelos deben decidir, a partir de imágenes estereoscópicas, si una persona ha cruzado un perímetro y ejecutar robot_stop(). Según el informe, las configuraciones que mantienen las paradas falsas por debajo del 5 % dejan escapar más del 40 % de los peligros reales; las que reducen esos fallos al entorno del 10–15 % detienen el robot innecesariamente entre el 15 % y el 25 % de las veces. Ningún modelo ocupa todavía la zona deseable de casi cero omisiones y casi cero falsas alarmas.
Google obtuvo números mejores en una demostración acotada con el humanoide Apollo 2: 99 % de detección humana y 96 % de transición fiable a una postura segura. Ambas cosas pueden ser ciertas. Un ensayo de garaje, con umbrales y recorridos preparados, muestra que la integración funciona; el benchmark más diverso muestra que no debe convertirse en la única barrera. La tarjeta del modelo prohíbe usarlo en trabajos críticos para la seguridad, incluidos salud y transporte, y pide discreción antes de operar en entornos públicos, comerciales o de producción.
El informe aporta otra lección menos vistosa. Cuando ER 2 sólo recibe una descripción mínima de las habilidades del VLA, clasifica correctamente como factibles o no factibles el 62 % de los encargos de una prueba. Con una descripción detallada de su distribución de entrenamiento, llega al 95,8 %. La seguridad del coordinador depende, por tanto, de un contrato legible sobre lo que cada herramienta sabe hacer. Inventariar capacidades, límites y estados de fallo no es documentación posterior: es parte del comportamiento del agente.
Mi lectura es que ER 2 ofrece un avance real precisamente porque no pretende aprender todos los movimientos de todos los robots. Convierte la planificación, la percepción temporal y la asignación de herramientas en una capa reutilizable. Esa modularidad también crea un lugar claro para intervenir: ante una orden ambigua, el agente puede preguntar; ante poca confianza, puede abstenerse; ante una alarma, puede pedir una parada.
Pero «puede pedir» no equivale a «parará a tiempo». Las barreras, límites de fuerza y velocidad, paradas de emergencia y controladores deterministas deben poder proteger el espacio aunque el modelo, la cámara o la conexión fallen. ER 2 puede añadir razonamiento semántico —entender que un recipiente metálico no debe entrar en un microondas— sobre esa base; no puede certificarla.
Hay además un coste de privacidad inseparable del bucle. La documentación advierte que el vídeo y el audio pueden captar voz, rostro e imagen de personas y exige información y consentimiento antes de que estén presentes alrededor del robot, además de minimizar datos y difuminar caras cuando sea posible. Un agente físico alojado en la nube no sólo mueve una máquina: convierte el lugar de trabajo o la casa en entrada continua del modelo.
La prueba responsable para un equipo no debería empezar preguntando cuánto tiempo puede actuar el robot solo, sino qué ocurre cuando interpreta mal un objeto, pierde un fotograma, recibe dos órdenes incompatibles o deja de tener red. El lanzamiento hace mucho más fácil construir el camino feliz. Su propio informe deja claro que el trabajo difícil es diseñar los caminos de duda, parada y recuperación sin delegarlos en la misma predicción que puede equivocarse.
Fuentes
- Google DeepMind, Introducing Gemini Robotics ER 2, 30 de julio de 2026.
- Google DeepMind, Gemini Robotics ER 2 Model Card, julio de 2026.
- Google AI for Developers, documentación y endpoints de Gemini Robotics ER, consultada el 31 de julio de 2026.
- Google DeepMind, Gemini Robotics 2: Safety Evaluations, 29 de julio de 2026.
- Google DeepMind, Gemini Robotics ER 1.6: Enhanced Embodied Reasoning, diciembre de 2025.