JOURNAL / 2026.08.02
SymptomAI mejora el diagnóstico diferencial al hacer preguntas
Un estudio nacional muestra que una entrevista de síntomas dirigida por el agente supera al chat guiado por el usuario; su comparación con médicos es prometedora, pero mucho más estrecha que un «médico de IA».
Google Research presentó el 22 de julio SymptomAI, un prototipo construido sobre Gemini 2.0 Flash para entrevistar a personas sobre síntomas y proponer un diagnóstico diferencial: una lista de causas posibles, no un diagnóstico confirmado. El paper había aparecido como preprint en mayo, pero merece una lectura ahora porque sustituye las viñetas clínicas preparadas por algo más difícil y realista: 13.917 conversaciones con usuarios de Fitbit que describieron problemas de salud con sus propias palabras.
El avance no consiste simplemente en que el modelo conozca enfermedades. Consiste en estudiar si sabe obtener la información que le falta. Entre junio de 2025 y abril de 2026, los participantes fueron asignados al azar a cinco formas de conversación. La condición base se parecía a un chat normal: el usuario decidía qué contar y el modelo respondía. Otras cuatro obligaban al sistema a preguntar por aspectos como inicio, localización, intensidad y evolución de los síntomas, bien siguiendo un guion clínico, bien escogiendo dinámicamente la siguiente pregunta.
El resultado está en la entrevista
Las cuatro estrategias que exigían preguntas de seguimiento lograron, en promedio, un 27,57 % más de precisión que la condición base según la medida del estudio. No hubo una diferencia estadísticamente significativa entre los dos enfoques dinámicos —en los que el modelo elegía qué preguntar— y los dos basados en preguntas clínicas canónicas. El dato no demuestra que improvisar siempre sea igual de seguro que seguir un protocolo. Sí muestra que la estructura de la interacción puede importar más que el hecho de abrir el mismo modelo y esperar una buena primera respuesta.
Eso cambia una decisión práctica para quien construye IA sanitaria. Un sistema que recibe «me duele el abdomen» no debería tratar la brevedad como si fuera toda la historia disponible. Debe saber qué información necesita, solicitarla sin dirigir indebidamente la respuesta y reconocer cuándo una conversación no basta. La capacidad relevante es un bucle: preguntar, actualizar posibilidades y decidir si puede seguir orientando o debe derivar. En esa arquitectura, el prompt y el flujo de conversación forman parte del instrumento clínico que se evalúa.
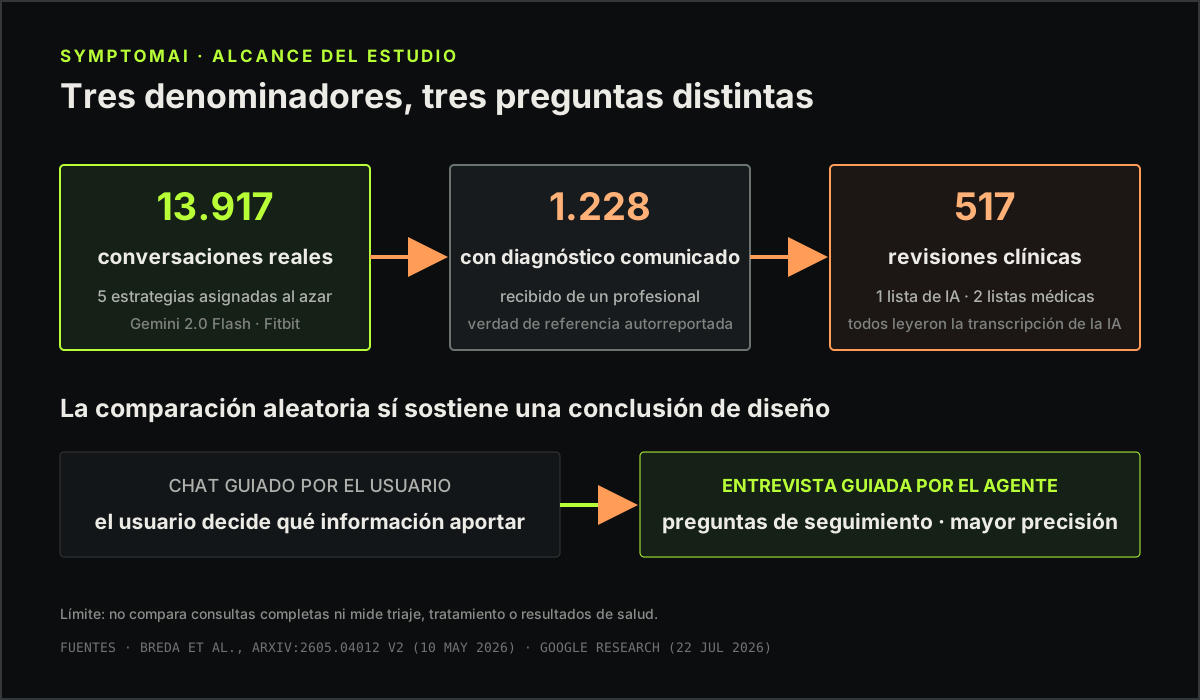
La comparación con médicos es el resultado más llamativo y el que exige más precisión. De las 13.917 personas, 1.228 comunicaron un diagnóstico recibido de un profesional sanitario. El análisis manual se redujo a 517 conversaciones aptas, revisadas por tres médicos de familia. Para cada caso se generaron tres listas: la de SymptomAI y dos listas de médicos que habían leído la misma transcripción. Un evaluador clínico independiente, sin conocer la autoría, situó la lista de SymptomAI en primer lugar en el 53,3 % de las evaluaciones; también apareció con más frecuencia el diagnóstico autorreportado entre sus cinco primeras opciones.
La comparación no es una consulta completa
«SymptomAI supera a los médicos» sería una conclusión demasiado amplia. Los médicos de referencia no entrevistaron a la persona: recibieron una conversación conducida por el propio sistema. Tampoco hubo una historia clínica verificada como verdad de referencia. El resultado final era lo que el participante recordaba y escribía sobre una visita sanitaria, y sólo una fracción del grupo aportó ese dato. La prueba mide la calidad de listas diferenciales sobre texto compartido, no exploración física, elección de pruebas, tratamiento, evolución del paciente ni seguridad del triaje.
La métrica top-5 tiene además un propósito concreto. Premia que la causa comunicada aparezca en algún lugar entre cinco posibilidades; no exige que ocupe el primer puesto ni mide si el sistema explica bien la incertidumbre. Una lista amplia puede ser útil para no omitir una posibilidad, pero en manos de un paciente también puede alarmar o tranquilizar indebidamente. Antes de convertir este resultado en producto habría que medir errores con consecuencias: señales de urgencia omitidas, derivaciones innecesarias, falsa seguridad y diferencias de rendimiento entre idiomas, grupos demográficos y condiciones poco frecuentes.
El estudio añade una segunda exploración con datos de Fitbit. Los autores usaron el primer diagnóstico de SymptomAI como etiqueta para las 13.917 conversaciones y buscaron cambios coincidentes en sueño, frecuencia cardiaca, respiración y otras señales. Encontraron asociaciones coherentes alrededor de infecciones agudas. Es evidencia de que algunas agrupaciones del modelo captan una señal fisiológica real, pero no una validación independiente de cada diagnóstico: el propio modelo define los grupos que después se comparan, y correlación temporal no equivale a causa ni a confirmación clínica.
Mi lectura es que el trabajo identifica una mejora pequeña en apariencia y profunda en diseño: no pedir al usuario que sepa de antemano qué dato médico importa. Un agente puede convertir una consulta vaga en un relato más útil para razonar o para preparar una visita. Eso puede ampliar el acceso a una primera orientación y mejorar la información que llega a un profesional.
El siguiente ensayo debería comparar recorridos completos: pacientes reales entrevistados por el sistema y por clínicos, con acceso apropiado a antecedentes, pruebas posteriores y seguimiento de resultados. También debería evaluar abstención y derivación, no sólo diagnósticos incluidos en una lista. Hasta entonces, SymptomAI es exactamente lo que declara el paper: un prototipo de investigación, no un dispositivo médico, una función comercial ni una autorización para sustituir atención profesional. Su contribución más sólida no es haber automatizado al médico, sino haber mostrado que un buen agente empieza por saber preguntar.
Fuentes
- Google Research, SymptomAI: Towards a conversational AI agent for everyday symptom assessment, 22 de julio de 2026.
- Joseph Breda et al., SymptomAI: Towards a Conversational AI Agent for Everyday Symptom Assessment, preprint revisado el 10 de mayo de 2026.
- Tao Tu et al., Towards conversational diagnostic artificial intelligence, Nature, 9 de abril de 2025.