JOURNAL / 2026.08.05
Alibaba lanza Qwen3.8-Max y promete abrir los pesos la próxima semana
El modelo de 2,4 billones de parámetros ya está en la API y una traza pública respalda uno de sus experimentos autónomos; los pesos, la licencia y la evidencia completa todavía no han llegado.
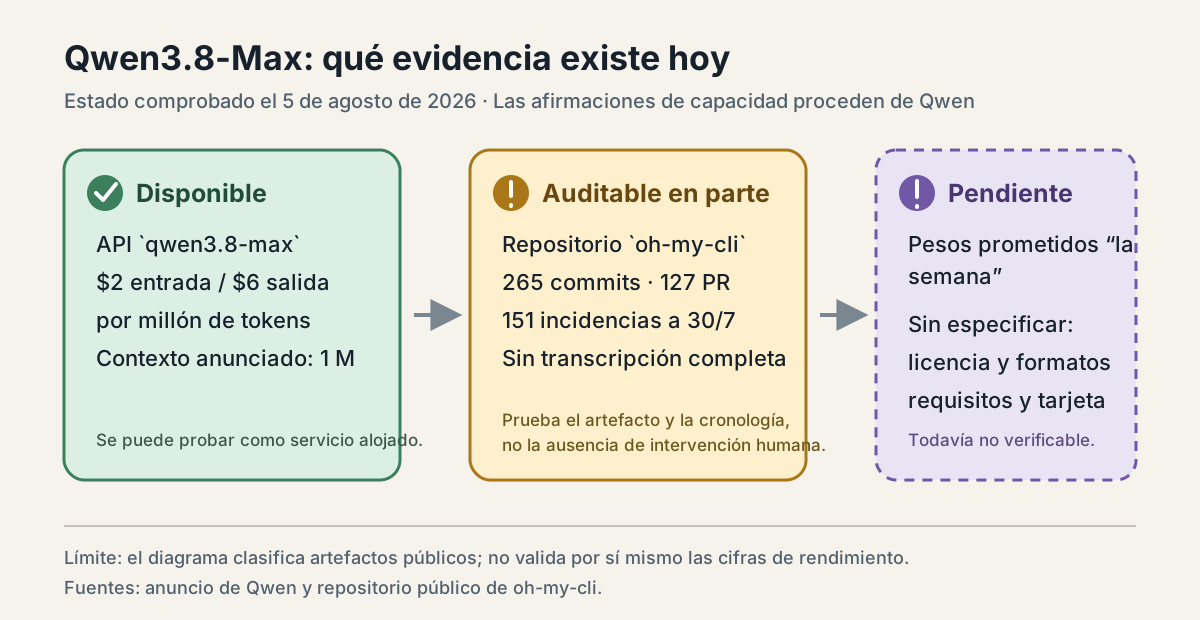
Alibaba presentó el 3 de agosto Qwen3.8-Max, un modelo nativamente multimodal de mezcla de expertos con 2,4 billones de parámetros totales y 95.000 millones activos. Ya se puede llamar como qwen3.8-max a través de QwenCloud, con una ventana de contexto anunciada de un millón de tokens. La empresa cobra 2 dólares por millón de tokens de entrada, 6 por millón de salida y 0,25 por millón de entrada recuperada de la caché.
Eso es un lanzamiento real, no sólo una demostración. Pero la parte que puede cambiar más el ecosistema todavía está en futuro: Qwen afirma que publicará los pesos en Hugging Face y ModelScope la próxima semana, por primera vez para un modelo de su clase Max. El anuncio técnico no identifica aún el repositorio, la licencia, el formato de los archivos ni los requisitos de inferencia.
La precisión verbal importa porque durante las últimas dos semanas qwen3.8-max-preview ya había estado disponible dentro de planes de suscripción. Lo nuevo es la versión oficial de la API, una descripción mucho más amplia de su entrenamiento y sus pruebas, y el compromiso público de publicar los pesos. Hoy Qwen3.8-Max es un servicio cerrado con una promesa de apertura fechada, no todavía un modelo de pesos abiertos.
Una traza pública, no una prueba completa de autonomía
Qwen no centra el lanzamiento en preguntas de examen. Su afirmación fuerte es que el modelo sostiene ciclos de trabajo durante días, observa resultados y modifica su plan. Presenta tres casos de programación: construir un agente desde una carpeta vacía durante más de diez días, reproducir y mejorar un paper mediante 33 entrenamientos, y competir durante 24 horas en un reto de reconocimiento multimodal.
El primer caso deja un objeto público especialmente útil. El repositorio qwen-code-dev-bot/oh-my-cli contiene un agente de terminal con sesiones persistentes, controles de comandos, recuperación, pruebas y un bucle que transforma incidencias en cambios revisados. Qwen dice que, a 30 de julio, una ejecución autónoma de unos 16 días había producido 265 commits, 127 pull requests y 151 incidencias. El historial público coincide con esas cantidades y muestra actividad desde el 13 de julio bajo la cuenta del bot.
Eso eleva mucho la evidencia respecto de un vídeo seleccionado: se puede inspeccionar el código, seguir la cronología, ver fallos y correcciones y comprobar que existe un producto sustancial. No demuestra, sin embargo, que Qwen3.8-Max hiciera todo el trabajo sin intervención humana. Una identidad de GitHub prueba quién firmó o envió una operación, no qué modelo estaba detrás, qué instrucciones recibió, cuándo una persona corrigió el rumbo ni cuánto cómputo consumió. El propio repositorio conserva reglas de gobernanza y recibos resumidos, pero no publica una transcripción íntegra y verificable de los dieciséis días.
Los otros casos tienen menos superficie independiente. Qwen asegura que el modelo partió del paper Unified Data Selection for LLM Reasoning, reconstruyó su método en unas 37 horas y empleó otras 88 en probar 18 ideas, hasta mejorar en 2,71 puntos su resultado reproducido en AIME24. También informa de 45 envíos al reto WWW2025 de Tianchi, con una precisión final de 0,853, y describe quinientos turnos de optimización de un acelerador criptográfico hasta reducirlo de 8.298 a 678 puertas sintetizadas.
Son resultados concretos y, si se reproducen, importantes. El anuncio enlaza el paper original y la página histórica del concurso, pero no el código, las trayectorias, los registros de entrenamiento ni el banco de pruebas del experimento de hardware. Por ahora esas cifras siguen siendo mediciones del proveedor. La diferencia entre los casos no es una sutileza: un repositorio permite auditar un resultado; una narración detallada sólo permite auditar lo que la empresa afirma haber medido.
Qué dicen —y qué no— las evaluaciones
La extensa tabla de Qwen sugiere un modelo muy fuerte, pero no uno que domine todo. En Terminal-Bench 2.1, que evalúa tareas verificables dentro de un terminal, la empresa declara un 86,6 %. En SWE-bench Pro, orientado a resolver incidencias de software en repositorios, declara un 67,7 %, por debajo del 80,0 % que atribuye a Claude Fable 5. Esta combinación encaja mejor con «competidor de frontera» que con «nuevo ganador universal».
Además, la propia nota metodológica impide leer cada columna como un experimento controlado único. Qwen3.8-Max se ejecuta con Claude Code en varias pruebas; otros resultados proceden del mejor dato publicado con otros harnesses; algunas comparaciones son mediciones internas de Qwen y varios conjuntos —incluidos sus bancos de programación y trabajo profesional— no son públicos. En Terminal-Bench usa hasta cinco horas y 131.072 tokens de salida por tarea. El precio por token ayuda a presupuestar una llamada, pero no revela el coste de una tarea completada tras herramientas, reintentos y muchas horas de ejecución.
La evidencia del lanzamiento sí permite una conclusión más modesta y útil. Qwen ha entrenado el modelo sobre entornos de refuerzo que varían tarea, espacio de trabajo y harness, y lo ha expuesto mediante protocolos compatibles con Responses de OpenAI y con la API de Anthropic. Para quien desarrolla agentes, la novedad práctica es poder cambiar el motor de un bucle existente y probar un contexto largo, visión y niveles configurables de razonamiento sin esperar a descargar nada.
La decisión de producción sigue requiriendo una evaluación propia. Los ejemplos profesionales del anuncio —asesoría legal, diseño estructural, rehabilitación o estrategia cuantitativa— comparan salidas del modelo con estimaciones de tiempo humano, pero no aportan revisiones independientes suficientes para delegar esas responsabilidades. «Entregable de aspecto terminado» y «resultado correcto bajo responsabilidad profesional» son categorías distintas.
El lanzamiento tiene una segunda fecha
Qwen3.8-Max parte de la arquitectura de Qwen3.5. El mayor modelo abierto de aquella familia, Qwen3.5-397B-A17B, tiene unos 397.000 millones de parámetros totales, 17.000 millones activos y licencia Apache 2.0. Llevar la clase Max de 2,4 billones de parámetros al mismo terreno permitiría inspeccionar y modificar un sistema mucho mayor que el anterior buque insignia abierto de Qwen.
«Abierto» no significará «fácil de ejecutar». Si los 2,4 billones de parámetros se distribuyeran a 16 bits, sólo los pesos rondarían 4,8 TB antes de metadatos; cuantizaciones y formatos distintos pueden reducir esa cifra, pero todavía no se conocen. Los 95.000 millones activos por token reducen el cálculo de cada paso, no la memoria necesaria para albergar todos los expertos. La publicación importará sobre todo a centros con infraestructura distribuida, proveedores de inferencia y grupos que quieran inspeccionar o adaptar el modelo.
También faltan datos que los pesos no resolverán por sí solos. El artículo no incluye una tarjeta de sistema específica ni una evaluación desarrollada de abuso, control de herramientas o seguridad de estas ejecuciones largas. Tampoco documenta el conjunto de entrenamiento, el coste de los casos, los intentos descartados o los puntos de intervención. Y hasta que aparezcan los archivos no se puede comprobar si la licencia permite realmente los usos que sugiere la palabra «abierto».
Mi lectura es que Qwen ha publicado una señal material de capacidad, pero también un buen examen para nuestra forma de leer lanzamientos. El repositorio de oh-my-cli vale más que una docena de capturas porque deja un resultado adversarialmente inspeccionable. Aun así, atribuir el historial entero al modelo exige una cadena de procedencia que el historial de Git no contiene. La afirmación de autonomía debe crecer al mismo ritmo que la evidencia de autonomía.
Por eso este lanzamiento tiene dos fechas. El 3 de agosto llegó el modelo alojado y una colección de resultados del proveedor. La semana próxima, si se cumple el anuncio, deberían llegar los pesos. Será entonces cuando podamos medir el tamaño real de la apertura: archivos, licencia, receta de ejecución, tarjeta técnica y posibilidad de repetir al menos una trayectoria larga. Si sólo aparecen varios terabytes de parámetros, Qwen habrá abierto el generador. Si publica además el sistema y la evidencia que convirtieron esos parámetros en dieciséis días de trabajo, habrá abierto una capacidad mucho más interesante.
Fuentes
- Qwen, Qwen3.8-Max: A New Bar for Coding and Cowork, 3 de agosto de 2026.
- Qwen, anuncio oficial de Qwen3.8-Max, 3 de agosto de 2026.
- qwen-code-dev-bot, repositorio público
oh-my-cli, consultado el 5 de agosto de 2026. - Qwen, Qwen3.5: Towards Native Multimodal Agents, 15 de febrero de 2026, y checkpoint Qwen3.5-397B-A17B.
- Li et al., Unified Data Selection for LLM Reasoning, 21 de mayo de 2026.
- Alibaba Cloud Tianchi, WWW2025 Multimodal Dialogue System Intent Recognition Challenge, 2024–2025.