JOURNAL / 2026.08.07
Microsoft libera Mage-VL, un modelo que lee vídeo desde el códec
El modelo de pesos abiertos evita volver a procesar gran parte de cada fotograma al reutilizar las señales de movimiento y cambio del vídeo comprimido; la ganancia es prometedora, pero todavía se ha medido en un entorno estrecho.
Un vídeo suele llegar ya comprimido, pero un modelo de visión acostumbra a deshacer ese trabajo: extrae fotogramas a intervalos regulares, los divide en una cuadrícula y procesa cada región aunque el fondo apenas haya cambiado. Mage-VL, publicado por un equipo de Microsoft, propone conservar una parte de la inteligencia que ya contiene el códec.
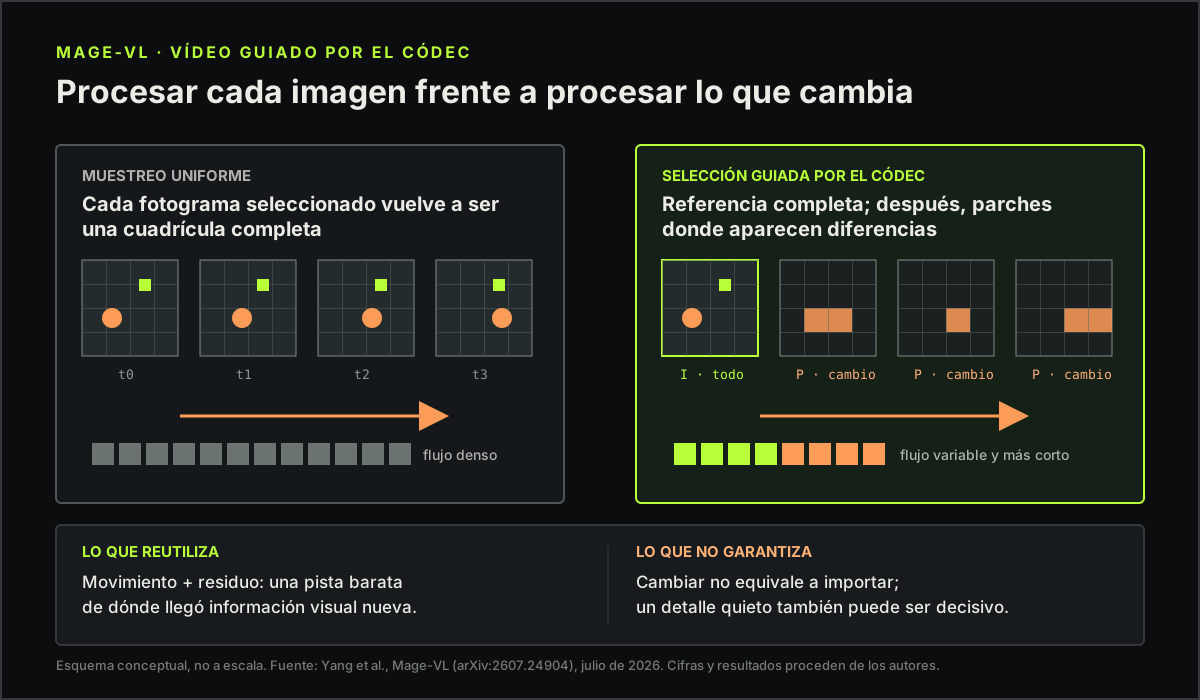
En formatos como H.264 o H.265, un fotograma de referencia —un I-frame— guarda una imagen completa. Los fotogramas predictivos posteriores —P-frames— describen sobre todo movimiento y diferencias respecto de lo anterior. Mage-VL procesa íntegramente los primeros y usa los vectores de movimiento y la energía residual de los segundos para escoger, en bloques de 16 por 16 píxeles, dónde merece gastar tokens visuales. El preprint, enviado el 27 de julio, atribuye a esa selección una reducción superior al 75 % frente a representar densamente los fotogramas muestreados.
La compresión se convierte en un sensor barato
La idea no es que movimiento equivalga a significado. Es que el compresor ya ha calculado una pista económica sobre dónde apareció información nueva. En vez de pedir al transformador visual que redescubra esa redundancia desde cero, Mage-VL la usa para construir una secuencia irregular de parches: todos los de los fotogramas de referencia y sólo los más cambiantes de los predictivos. Las posiciones tridimensionales conservan cuándo y dónde apareció cada fragmento.
Este principio antecede al nuevo modelo. Parte del equipo publicó en febrero OneVision-Encoder, que ya estudiaba la dispersión alineada con el códec. Mage-VL da un paso práctico: combina un codificador visual entrenado desde cero con un decodificador Qwen3 de 4.000 millones de parámetros, añade una puerta ligera que decide cuándo un acontecimiento merece respuesta y entrega un único checkpoint para imágenes, vídeo grabado y transmisión continua.
Los artefactos importan tanto como la arquitectura. Los pesos de Mage-VL —dos archivos BF16 que suman unos 9,5 GB— y el codificador Mage-ViT están publicados con licencia Apache 2.0. El repositorio de Microsoft ofrece código bajo licencia MIT para inferencia por fotogramas, por códec tradicional y por códec neuronal, además del modo de transmisión. No se ha abierto el conjunto completo de entrenamiento, pero sí existe superficie suficiente para inspeccionar la implementación, cambiar el presupuesto de parches y repetir una parte importante de la evaluación.
Qué demuestra la comparación y qué deja fuera
La comparación más útil del artículo mantiene el mismo decodificador lingüístico de 4.000 millones de parámetros que Qwen3-VL-4B y cambia principalmente la entrada visual. Los autores informan de mejoras en la mayoría de sus pruebas de vídeo largo, localización temporal y razonamiento espacial, aunque Qwen conserva ventaja en algunas tareas que dependen más de la apariencia densa de cada fotograma. Ese reparto es más informativo que declarar un ganador general: la selección por cambios favorece precisamente los problemas donde importa seguir qué ocurrió y cuándo.
El máximo anunciado de 3,5 veces más velocidad de inferencia tampoco es una propiedad universal del modelo. Procede de ejecuciones de los autores en un único nodo con ocho GPU B200, varía según la prueba y el presupuesto de tokens, y algunas filas de la propia tabla no son más rápidas que el control. Mide tiempo de evaluación, no latencia de producción desde una cámara heterogénea hasta una respuesta. No hay todavía reproducción independiente, comparación energética ni distribución de latencias que permita prometer «tiempo real» en otro equipo.
La puerta proactiva añade otra capacidad interesante: observa ventanas consecutivas y permanece callada hasta que estima que un evento ha terminado. El artículo la evalúa principalmente en retransmisiones de fútbol y en un protocolo de comprensión de vídeo en línea. Eso prueba que el mecanismo puede aprender cuándo hablar en una distribución concreta; no demuestra que detecte de forma fiable una caída lenta, una anomalía industrial rara o un gesto relevante en una cámara distinta.
Aquí aparece el límite conceptual. Un códec asigna bits para reconstruir una señal, no para proteger su significado. Un objeto pequeño y estático puede ser decisivo aunque genere poco residuo; un cambio de iluminación o ruido de cámara puede consumir muchos bits sin importar para la tarea. Mage-VL aprende sobre esos indicios y conserva fotogramas completos periódicos, de modo que no depende de una regla ciega. Aun así, el preprint no presenta una evaluación dedicada a fallos por «detalle semántico inmóvil», ni una sección específica de seguridad o limitaciones.
Mi lectura es que la contribución más valiosa no es una nueva puntuación de vídeo, sino mover el ahorro hacia el principio de la tubería. Si un sistema reduce los tokens antes del codificador visual, ahorra trabajo en cada capa posterior y puede mantener una historia temporal más larga con el mismo presupuesto. Eso puede hacer más viables subtítulos en directo, búsqueda en archivos audiovisuales, asistencia visual o supervisión de procesos en infraestructura propia.
También agranda la obligación de diseñar el entorno. Un modelo de pesos abiertos que permanece mirando una transmisión no es sólo un clasificador más barato: puede observar personas, conservar contexto y emitir alertas sin una pregunta explícita. La publicación no resuelve consentimiento, retención, sesgo entre tipos de cámara ni qué acción sigue a una detección. La eficiencia vuelve posibles más ojos; no decide dónde es legítimo colocarlos.
Mage-VL merece atención por una razón sobria: trata el vídeo comprimido como una estructura computacional, no como una bolsa de imágenes. Los pesos y el código permiten comprobar si esa intuición sobrevive fuera de la tabla del equipo. La prueba decisiva será menos vistosa que un benchmark: medir en cámaras, códecs y acontecimientos no vistos cuántos detalles relevantes se pierden por cada unidad de cómputo ahorrada.
Fuentes
- Yang et al., Mage-VL: An Efficient Codec-Native Streaming Multimodal Foundation Model, preprint, 27 de julio de 2026.
- Microsoft, modelo y tarjeta de Mage-VL y codificador Mage-ViT, consultados el 7 de agosto de 2026.
- Microsoft, código de Mage-VL, consultado el 7 de agosto de 2026.
- Tang et al., OneVision-Encoder: Codec-Aligned Sparsity as a Foundational Principle for Multimodal Intelligence, preprint, 9 de febrero de 2026.