JOURNAL / 2026.08.11
Meta libera Muse Glimmer, un modelo agente de 30.000 millones para ejecutar en local
Los pesos y las cuantizaciones de Muse Glimmer caben en hardware de consumo; el lanzamiento acerca agentes multimodales al dispositivo, pero no vuelve locales ni seguros por defecto sus herramientas, credenciales y acciones.
Meta publicó el 10 de agosto Muse Glimmer, un modelo denso de 30.000 millones de parámetros afinado para agentes, con entrada de texto e imagen y pesos descargables. No es una demostración cerrada ni el anuncio de unos pesos futuros: el repositorio de precisión completa y el de cuantizaciones GGUF son públicos, no requieren aprobación y contienen los archivos descritos en la tarjeta del modelo. Meta los distribuye bajo Apache 2.0, junto con una política de uso separada.
Lo material del lanzamiento no es que un modelo de este tamaño pueda comprimirse. Es que Meta ha preparado el paquete completo para que un modelo multimodal entrenado expresamente en tareas de agente funcione dentro de la memoria de una sola GPU de consumo: pesos cuantizados, componente visual y un pequeño modelo auxiliar para acelerar la generación. Eso reduce una dependencia importante de la nube. No elimina las demás.
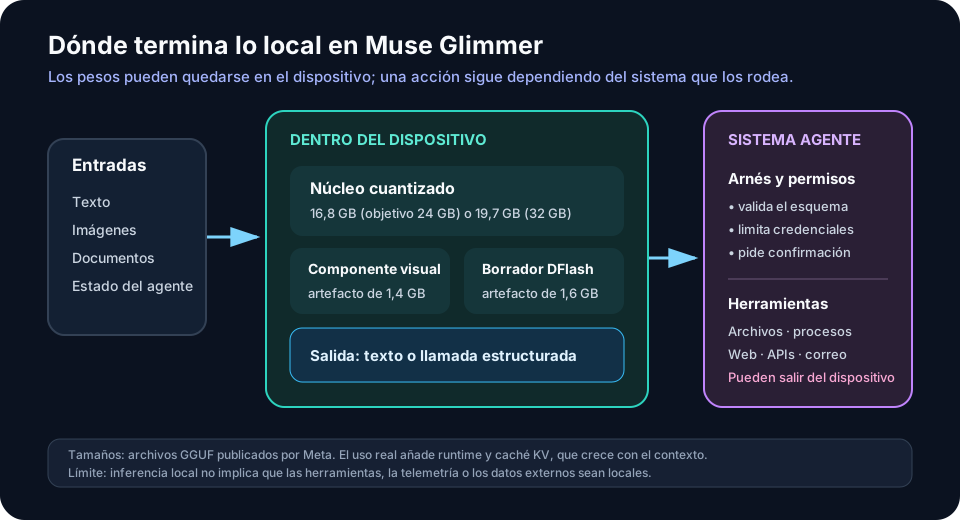
Lo local cabe en una GPU; el agente completo no cabe en los pesos
La tarjeta del modelo describe un transformador denso de unos 29.600 millones de parámetros, 52 capas, contexto máximo de 131.072 tokens y un codificador visual de aproximadamente 1.800 millones de parámetros. Fue destilado de Muse Spark: durante el preentrenamiento aprendió de sus distribuciones de salida, después recibió datos de contexto largo y mayor concentración de tareas de agente, y finalmente combinó ajuste supervisado, destilación sobre trayectorias propias y aprendizaje por refuerzo.
Los archivos permiten comprobar qué significa «local» en este caso. Los dos fragmentos BF16 suman unos 59,6 GB. Las versiones cuantizadas reducen el núcleo lingüístico a 16,8 o 19,7 GB; el repositorio añade un componente visual de 1,4 GB y un borrador DFlash de 1,6 GB. Meta apunta la primera configuración a dispositivos con 24 GB de memoria y la segunda a 32 GB. La memoria real también debe alojar el runtime y la caché KV, que crece con el contexto: que la arquitectura admita 131.072 tokens no demuestra que toda esa ventana sea práctica en la configuración mínima.
DFlash propone bloques de 16 tokens que el modelo principal verifica en paralelo. En las mediciones de Meta, con lote uno y decodificación codiciosa, la combinación elevó la generación en una RTX 5090 de 74,9 a 233,4 tokens por segundo; en un MacBook M4 Max pasó de 23,7 a 37,8. Son pruebas del proveedor sobre un conjunto de indicaciones que no se publica en la tarjeta, útiles para entender el mecanismo y el orden de magnitud, no una promesa de velocidad para cualquier agente. Una tarea con herramientas también espera redes, procesos, páginas y confirmaciones: los tokens por segundo son sólo una parte de su latencia.
Meta compara Muse Glimmer con Gemma 4 31B y Qwen3.6 27B. En su evaluación obtiene 75,5 en MCP Atlas, por encima de 54,2 y 62,5 respectivamente, y 51,2 en SWE-Bench Pro, muy cerca del 50,2 de Qwen. Pero Qwen queda por delante en OSWorld-Verified, 75,6 frente a 65,9, y en Terminal-Bench 2.1. El informe metodológico documenta los arneses y ajustes usados, pero los resultados siguen siendo ejecuciones organizadas por Meta y mezclan varias clases de tarea. No sustentan un «mejor modelo local» universal. Sí sostienen una afirmación más limitada y útil: la cuantización no ha borrado la competencia agente del modelo, y el paquete puede abordar código, uso de herramientas y lectura visual sin enviar cada inferencia a una API.
Esa combinación cambia lo que puede construirse. Un asistente que clasifica documentos privados, consulta archivos o prepara llamadas a herramientas puede mantener el razonamiento y parte del contexto en el dispositivo. La latencia y el coste marginal dejan de depender de una petición remota para cada paso. Los pesos completos, además, permiten estudiar, adaptar y servir el modelo sin quedar atado a una única interfaz comercial.
Pero un modelo no mueve el ratón, envía un correo ni modifica un repositorio por sí solo. Produce texto y llamadas estructuradas. Un arnés decide qué herramientas existen, convierte la salida en una operación, administra credenciales, limita permisos y solicita confirmación. Si una herramienta consulta Gmail, una web o un servicio de pagos, esa parte sigue cruzando la red. Si el arnés registra telemetría o carga archivos, tener los pesos en el portátil no lo impide. «Inferencia local» es una propiedad verificable; «agente privado» sólo lo es después de auditar todo el flujo.
Abrir los pesos traslada control, y también responsabilidad
La apertura aquí es considerable. Los pesos BF16 permiten ajuste e inspección; los GGUF acercan el uso inmediato; la licencia Apache 2.0 admite uso comercial y obras derivadas; y el lanzamiento incluye el componente visual y el acelerador, no sólo un checkpoint difícil de ejecutar. Algunas integraciones anunciadas con Ollama, LM Studio, MLX y otros marcos llegarán «en los próximos días», así que disponibilidad de archivos y experiencia madura de instalación todavía no son lo mismo.
La contrapartida es que las salvaguardas del servicio dejan de ser un perímetro común. Meta recomienda confirmación humana para acciones irreversibles y defensas específicas de cada aplicación. Sus propios resultados explican por qué. En Siren AgentDojo, que introduce instrucciones adversarias durante el uso de herramientas, Muse Glimmer conserva una utilidad del 94,2%, pero el ataque aún tiene éxito en el 28,4% de los casos. Es mejor que el 40,3% atribuido a Qwen en la misma tabla y algo peor que el 25,6% de Gemma. En CI Memories, su tasa de violación de flujos apropiados de información es 26,4%. Ninguno de esos números puede trasladarse directamente a una aplicación concreta, pero ambos contradicen la idea de que ejecutar el modelo localmente resuelve por sí mismo la inyección de instrucciones o el uso indebido de datos.
También conviene leer con cuidado la evaluación de preparación. Meta clasifica el riesgo químico y biológico como moderado o menor. Para ciberseguridad y pérdida de control, en cambio, la tarjeta infiere ese nivel porque Glimmer es, en general, menos capaz que Muse Spark 1.0, no porque publique una evaluación directa completa de ambos dominios para este modelo. La inferencia puede ser razonable como decisión de lanzamiento; es una base más débil para que terceros dimensionen un despliegue con herramientas potentes.
Mi lectura es que Muse Glimmer hace más interesante el agente local precisamente porque obliga a dejar de usar «local» como sinónimo de «seguro». La privacidad mejora cuando entradas, memoria y razonamiento permanecen en una máquina controlada por el usuario. La seguridad mejora cuando permisos, confirmaciones y aislamiento están bien diseñados. Son avances compatibles, pero distintos. Un modelo abierto permite verificar el primer límite y modificar el comportamiento; no certifica el segundo.
La evidencia que falta es práctica: reproducciones independientes de las pruebas con las cuantizaciones publicadas, medidas de contexto y velocidad en hardware más común que una RTX 5090, y evaluaciones de agentes completos donde se vea qué datos abandonan el dispositivo y qué ocurre ante una instrucción maliciosa dentro de un documento o una web. Meta ha entregado una base poco habitual: un modelo agente multimodal, permisivamente licenciado y realmente descargable, con una ruta plausible a una sola GPU. Ahora la unidad de análisis ya no puede ser sólo el modelo. Debe ser la cadena que une pesos, memoria, arnés, credenciales y acción.
Fuentes
- Meta AI Research, Introducing Muse Glimmer: An Open Agentic Model That Runs on Your Device, 10 de agosto de 2026.
- Meta Superintelligence Lab, tarjeta y pesos BF16 de Muse Glimmer 30B y artefactos GGUF cuantizados, consultados el 11 de agosto de 2026.
- Meta, Muse Glimmer Eval Methodology, agosto de 2026.
- Chen, Liang y Liu, DFlash: Block Diffusion for Flash Speculative Decoding, preprint, 5 de febrero de 2026; versión revisada aceptada en ICML 2026.
- Meta, Advanced AI Scaling Framework, referencia para la evaluación de preparación del lanzamiento.