JOURNAL / 2026.08.13
Alibaba publica los pesos de Qwen3.8-Max, pero no todo el servicio de la API
El checkpoint de 2,4 billones de parámetros ya puede descargarse en BF16 y FP8; abre el núcleo del modelo a despliegues propios, aunque deja fuera la visión y varias funciones del servicio y conserva condiciones comerciales propias.
La segunda fecha de Qwen3.8-Max ya ha llegado. El 12 de agosto, nueve días después de lanzar el modelo en su API, Alibaba terminó de publicar en Hugging Face el checkpoint BF16 y una versión cuantizada a FP8. Ambos repositorios son públicos, no requieren aceptar una solicitud de acceso y contienen los 213 fragmentos de pesos que declaran sus índices.
Esto convierte una promesa en un artefacto: por primera vez, el núcleo de un modelo de clase Qwen-Max puede descargarse, inspeccionarse, modificarse y servirse fuera de la infraestructura de Alibaba. Es una apertura importante incluso para quienes nunca vayan a alojarlo. Permite que proveedores competidores, centros de investigación y grupos con grandes clústeres estudien el mismo generador que sostiene el producto, en lugar de inferir su comportamiento sólo mediante una API.
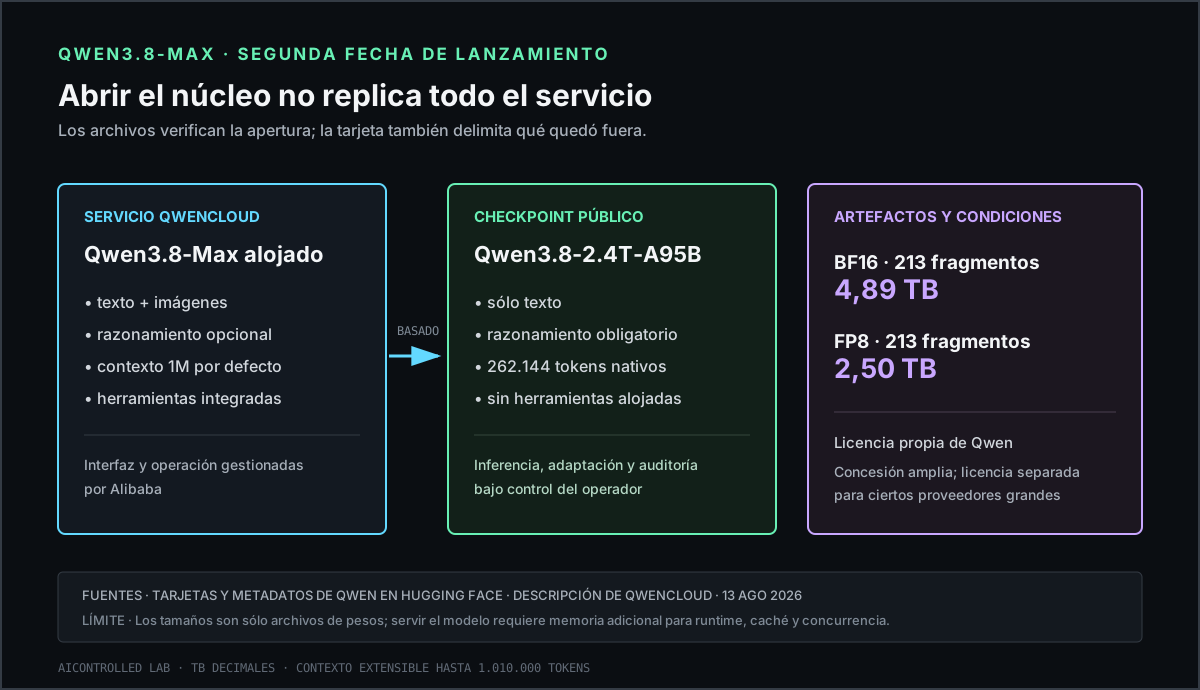
Pero «los pesos de Qwen3.8-Max» y «Qwen3.8-Max tal como se vende» no son objetos idénticos. La propia tarjeta lo advierte. El checkpoint publicado sólo admite texto y obliga a usar el modo de razonamiento; el servicio añade entrada visual, respuestas sin razonamiento, herramientas integradas y un contexto de un millón de tokens por defecto. La publicación abre el motor lingüístico. No clona el vehículo completo.
Dos terabytes y medio siguen siendo infraestructura de centro de datos
Los archivos permiten sustituir estimaciones por una medida. Los 213 fragmentos BF16 suman 4,89 TB; los 213 FP8, 2,50 TB. Son tamaños decimales de los pesos publicados, no requisitos completos de memoria. El servidor también necesita el runtime, estados intermedios y una caché que crece con el número de usuarios y la longitud del contexto.
La mezcla de expertos explica por qué dos cifras verdaderas pueden inducir a error. La arquitectura tiene 2,4 billones de parámetros totales y activa unos 95.000 millones por token. Activar una fracción reduce el cálculo de cada paso, pero no permite desechar los demás expertos: todos deben estar disponibles cuando el enrutador los elija. Por eso Qwen3.8-Max no se despliega como si fuera un modelo denso de 95.000 millones.
La receta de vLLM dimensiona el problema con hardware concreto. Para servir el FP8 completo calcula dos nodos de ocho GPU B300 o cuatro nodos de ocho H200; BF16 eleva esas configuraciones a tres y seis nodos, respectivamente. Son diseños de referencia, no un mínimo universal: la longitud real de contexto, la concurrencia, las cuantizaciones posteriores y el rendimiento buscado pueden cambiar mucho la instalación. Sí dejan claro que el lanzamiento no convierte el buque insignia en un modelo local para una estación de trabajo.
Qwen publica una longitud nativa de 262.144 tokens y una extensión hasta 1.010.000. La extensión tampoco es memoria gratuita. Una aplicación que quiera acercarse al millón necesita reservar espacio para estados de atención y razonamiento muy largos, además de tolerar su latencia. La tarjeta recomienda hasta 262.144 tokens sólo para el razonamiento y otros 131.072 para la respuesta en tareas agénticas. Es capacidad disponible, no una configuración sensata por defecto para cada petición.
FP8 reduce casi a la mitad el peso de los archivos. Alibaba dice que su método por bloques conserva resultados «casi idénticos» al original, pero no publica en la tarjeta una tabla separada para esa variante. Hasta que existan reproducciones, conviene tratar la equivalencia como una afirmación del proveedor. Los checkpoints de terceros a cuatro bits pueden bajar más el umbral de hardware, a cambio de introducir otra implementación y otra posible pérdida que no forman parte de esta publicación oficial.
El checkpoint abierto es más estrecho que el producto cerrado
La diferencia funcional es más importante que una casilla de formato. El modelo alojado puede recibir imágenes y combinar esa percepción con herramientas. Los archivos públicos declaran una arquitectura causal de texto, no contienen un codificador visual y su guía dice expresamente que la entrada multimodal no está soportada. Un equipo puede reconstruir un agente de código o investigación sobre el checkpoint; no puede asumir que repetirá los casos visuales del anuncio con esos archivos.
También cambia el control de razonamiento. En la API se puede elegir una respuesta sin pensamiento visible; el checkpoint exige que cada turno empiece por un bloque de razonamiento. Ofrece tres niveles de esfuerzo y puede conservar ese razonamiento entre mensajes, pero no permite desactivarlo según la configuración soportada por Qwen. Esto afecta coste, latencia, privacidad de las trazas y compatibilidad con aplicaciones que esperaban una salida corta.
Las herramientas integradas tampoco viven dentro de los parámetros. Un despliegue propio debe aportar el servidor, el analizador de llamadas, el harness, los permisos, el aislamiento y las confirmaciones. Qwen proporciona plantillas y compatibilidad con vLLM, SGLang y TokenSpeed; no publica aquí el sistema completo que produjo sus ejecuciones de varios días. Los pesos permiten intentar una reproducción de oh-my-cli o de sus pruebas de terminal. No aportan las trayectorias completas, los datos de refuerzo, todos los intentos fallidos ni una receta que convierta esa reproducción en automática.
Hay una ausencia especialmente relevante para un modelo entrenado para trabajo largo con herramientas. Los repositorios contienen pesos, configuración, tokenizador, plantilla de conversación, guía y licencia, pero no enlazan una tarjeta de seguridad específica ni publican evaluaciones desarrolladas de inyección de instrucciones, abuso cibernético, autonomía o control de acciones. Las tablas de capacidad son las mismas mediciones del proveedor que acompañaron al lanzamiento de la API. Abrir los parámetros hace posibles auditorías que antes no podían hacerse; no sustituye la evaluación que el creador todavía no ha mostrado.
La licencia abre muchos usos, no todos
Qwen3.8-Max tampoco hereda Apache 2.0 de Qwen3.5-397B-A17B, el anterior gran modelo abierto de la familia. Su licencia propia concede derechos amplios para usar, modificar, distribuir, alojar y afinar el software, también con fines comerciales, pero añade condiciones por escala y tipo de negocio.
Un producto comercial que supere 100 millones de usuarios activos mensuales o 20 millones de dólares de ingresos al mes debe mostrar de forma prominente el nombre del modelo. La restricción más sustancial afecta a empresas de modelo como servicio o de asistentes de programación y oficina: si ellas y sus afiliadas superan 50 millones de dólares de ingresos agregados en doce meses consecutivos, necesitan otra licencia de Qwen para usar el modelo comercialmente, salvo para uso interno sin ofrecer el modelo, sus salidas o sus capacidades a terceros.
Para investigación, despliegues internos y muchas empresas pequeñas, la concesión sigue siendo muy amplia. Para un proveedor grande que quiera competir directamente con QwenCloud o Qoder, no es permiso sin condiciones. La etiqueta correcta es pesos abiertos con licencia propia, no código abierto en el sentido habitual ni dominio libre de control comercial. El cambio respecto de Apache parece deliberado: Alibaba abre su modelo más grande a estudio y adopción, mientras conserva una negociación sobre algunos rivales a escala.
Mi lectura es que la publicación cumple la parte central de la promesa y, al mismo tiempo, vuelve más precisa la palabra «abrir». Ya no dependemos de capturas para saber qué arquitectura hay, cuánto ocupa o qué permite la licencia. Los archivos son reales y suficientes para que actores con infraestructura institucional controlen la inferencia y modifiquen el modelo. Eso cambia quién puede experimentar en la frontera abierta.
No cambia quién puede hacerlo con facilidad, ni convierte el checkpoint en una copia soberana de la API. Visión, herramientas alojadas, modos de respuesta, evidencia de seguridad y economía de operación siguen formando otra capa. La prueba valiosa ahora no será que alguien consiga cargar 2,50 TB y generar una respuesta, sino que varios equipos midan qué capacidad sobrevive en FP8, cuánto cuesta una tarea completa, cómo se comporta el modelo bajo instrucciones adversarias y qué hace falta para reconstruir un agente largo sin los servicios de Alibaba. La apertura ha pasado de promesa a infraestructura; la reproducibilidad completa todavía no.
Fuentes
- Qwen, Qwen3.8-Max: A New Bar for Coding and Cowork, 3 de agosto de 2026.
- Qwen, checkpoint Qwen3.8-2.4T-A95B en BF16 y checkpoint oficial FP8, publicados el 12 de agosto de 2026 y consultados el 13 de agosto.
- Qwen, licencia de Qwen3.8-Max, 12 de agosto de 2026.
- QwenCloud, descripción del servicio alojado Qwen3.8-Max, consultada el 13 de agosto de 2026.
- vLLM, receta de despliegue para Qwen3.8-2.4T-A95B, actualizada el 10 de agosto de 2026.