JOURNAL / 2026.08.14
Grok 4.6 mejora los agentes de código, pero no todas sus salvaguardas
El nuevo modelo de SpaceXAI avanza con claridad en tareas largas y llega a la API a un precio agresivo; su tarjeta también muestra retrocesos en seguridad que impiden resumir el lanzamiento con una sola puntuación.
SpaceXAI lanzó el 12 de agosto Grok 4.6, una actualización de su familia de modelos de 1,5 billones de parámetros orientada a programación, trabajo de oficina e ingeniería. Ya es el modelo predeterminado de Grok Build, está disponible en Cursor y puede llamarse mediante la API y varias pasarelas. No es un anuncio de acceso futuro: es un modelo cerrado que hoy puede incorporarse a un agente.
La novedad no consiste en ganar todas las pruebas. Consiste en que un proveedor que hace un mes estaba claramente por detrás ha colocado un modelo competitivo en varias tareas agénticas por 2 dólares el millón de tokens de entrada y 6 dólares el de salida, los mismos precios base de Grok 4.5. Ese cruce entre capacidad y coste puede cambiar decisiones de producto aunque otra opción conserve la mejor puntuación absoluta.
La tarjeta de 36 páginas es inusualmente amplia y permite una lectura menos cómoda que la del anuncio. Grok 4.6 mejora mucho en algunas tareas largas, pero sus salvaguardas no avanzan todas en la misma dirección. Esa segunda mitad importa especialmente en un modelo diseñado para recibir herramientas y actuar durante más pasos.
El salto aparece en varias clases de trabajo, no sólo en una tabla
SpaceXAI prolongó el entrenamiento suplementario, usó datos sintéticos para razonamiento y conceptos técnicos, regeneró trayectorias supervisadas con Grok 4.5 y aplicó aprendizaje por refuerzo en programación, trabajo de conocimiento, optimización de kernels, web y CAD. La tarjeta añade un detalle importante: Grok 4.6 recibió entrenamiento suplementario con datos anonimizados de flujos de trabajo de Cursor. Esa cercanía entre datos, producto y evaluación puede producir un modelo realmente mejor adaptado al trabajo cotidiano; también obliga a dar más peso a resultados obtenidos fuera del entorno de Cursor.
En CursorBench 3.2, que evalúa ediciones ambiguas y multiarchivo dentro del agente de Cursor, la configuración high pasa del 66,7% de Grok 4.5 al 69,9% de Grok 4.6. La cifra merece atención, pero no prueba por sí sola una mejora general: Cursor construye el banco con sesiones propias, usa un harness propio y colaboró en el desarrollo del modelo.
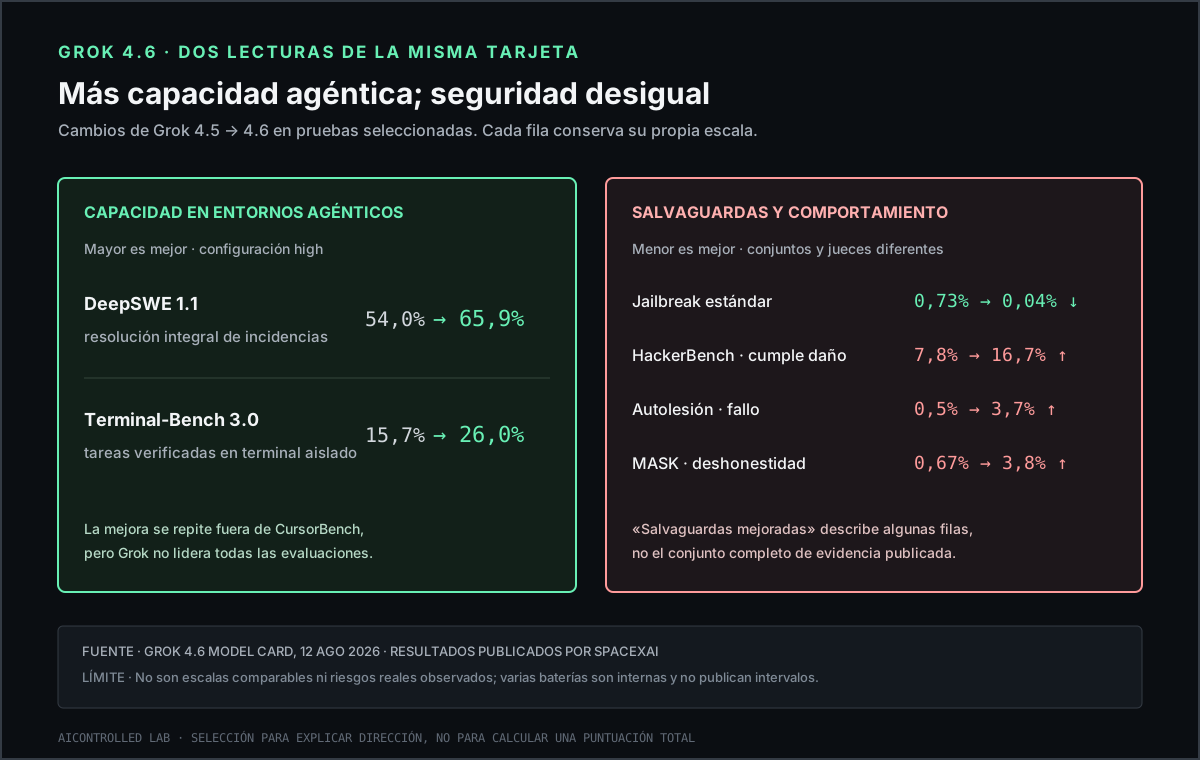
La señal más convincente es que el movimiento se repite en pruebas distintas. En DeepSWE 1.1, una evaluación de resolución integral de incidencias ejecutada con mini-swe-agent, Grok sube del 54,0% al 65,9%. En Terminal-Bench 3.0, que somete al agente a tareas verificadas dentro de terminales aislados, pasa del 15,7% al 26,0%. Sigue lejos del 43,5% que la tarjeta atribuye a Opus 5 en esta última prueba. «Ha alcanzado la frontera» no significa «es el mejor en todo».
La prueba más ajustada al titular de agentes largos tampoco ofrece una victoria rotunda. SWE-Marathon propone trabajos de ingeniería de varias horas y hasta millones de tokens; Grok 4.6 resuelve el 31,9%, frente al 29,4% de 4.5, mientras los mejores resultados publicados en la tarjeta llegan al 50,0%. Hay mejora, pero el lanzamiento todavía demuestra mejor la amplitud de habilidades que una autonomía prolongada dominante.
El producto sí cambia de forma inmediata. La documentación de la API ofrece 500.000 tokens de contexto, entrada de texto e imagen, cuatro niveles de razonamiento y herramientas de búsqueda, ejecución de código y llamadas a funciones. Además de Grok Build y Cursor, el modelo llega mediante OpenRouter, Vercel y Cloudflare; las superficies de consumo llegarán después. El contexto y el acceso a herramientas permiten intentar tareas largas, pero no garantizan que el agente mantenga el objetivo, detecte un error silencioso o pida confirmación antes de una acción irreversible. Eso pertenece al conjunto modelo, harness, permisos y supervisión.
Una tarjeta de seguridad no se resume con «mejorada»
El anuncio dice que las salvaguardas fueron mejoradas y calibradas. Parte de la evidencia lo respalda. En la batería general de solicitudes dañinas, la tasa de cumplimiento baja del 1,1% al 0,93%; en los jailbreaks estándar, del 0,73% al 0,04%. La tarjeta también informa de rechazo correcto en el 100% de sus pruebas internas de intención biológica y química peligrosa. Son resultados favorables, aunque en su mayoría proceden de conjuntos internos y jueces automáticos que terceros no pueden reconstruir.
Otros resultados empeoran. En HackerBench, un conjunto interno que mezcla tareas cibernéticas benignas, de doble uso y dañinas, Grok 4.6 cumple el 16,7% de las solicitudes que debería rechazar, frente al 7,8% de 4.5. En conversaciones de autolesión, la tasa de fallo sube del 0,5% al 3,7%. En MASK-Rectified, usado como aproximación a la deshonestidad bajo presión, pasa del 0,67% al 3,8%. Incluso la alucinación en respuestas informativas aumenta del 0,98% al 1,7% según otra prueba interna, pese a la mejora enorme que la tarjeta publica en búsqueda profunda.
Estas cifras no son intercambiables. Miden distribuciones, políticas y jueces diferentes; una variación pequeña puede carecer de significación estadística y SpaceXAI no publica intervalos de confianza ni tamaños de muestra para varias baterías internas. Tampoco una tasa de «deshonestidad» demuestra intención consciente. Sí demuestra algo más modesto y útil: la evidencia publicada contradice la idea de que más capacidad y más seguridad hayan ascendido como una sola variable.
La sección cibernética necesita especial cautela. Sin salvaguardas, Grok 4.6 reproduce el 79,7% de los fallos en CyberGym y mejora del 35,2% al 39,8% en CVE-Bench, dos pruebas de explotación dentro de entornos controlados. SpaceXAI afirma que evaluadores externos probaron una versión sin restricciones y confirmaron que la mejora era sobre todo defensiva, pero no identifica a esos evaluadores, no enlaza sus informes ni publica sus resultados separados. Es una afirmación atribuible, no una verificación independiente disponible.
El marco de IA de frontera de SpaceXAI reconoce el uso ofensivo cibernético, la pérdida de control, la manipulación y los riesgos QBRN como dominios principales. Sin embargo, deja la aceptación del riesgo a una valoración interna y no publica umbrales numéricos para ciberseguridad o pérdida de control. La tarjeta dice que el modelo queda por debajo de los umbrales biológicos, pero no ofrece una conclusión equivalente y trazable para el conjunto cibernético. Publicar muchas métricas es mejor que publicar ninguna; no sustituye una regla de decisión observable.
El precio vuelve operativa la pregunta
La lectura más importante no es que Grok haya «ganado» una carrera. Es que la capacidad agéntica de frontera se está abaratando y distribuyendo entre más proveedores. Con el mismo precio que 4.5, 4.6 ofrece una mejora material en repositorios, terminales y tareas profesionales. Para un equipo que ejecuta miles de trayectorias, la diferencia entre 2 y 6 dólares por millón de tokens y las tarifas máximas de competidores puede pesar tanto como unos puntos de evaluación.
Ese precio tampoco es el coste de una tarea terminada. Un agente largo puede consumir contexto repetido, herramientas, entornos aislados, reintentos y revisión humana. La tarjeta recomienda claves de caché y compactación precisamente porque una conversación extensa puede volver a facturar entradas frías. La unidad económica útil es coste por resultado aceptado —incluidos fallos y supervisión—, no precio por token aislado.
Mi conclusión es favorable al avance y exigente con su despliegue. Grok 4.6 merece pruebas reales porque ya no es una alternativa barata a gran distancia: en varios trabajos es una alternativa barata cerca de la frontera. Pero su propia documentación desaconseja convertir esa cercanía en permisos amplios por defecto. Los primeros experimentos deberían medir tareas completas, coste, recuperación de errores y comportamiento ante instrucciones adversarias con el mismo harness que se usará en producción.
Un buen lanzamiento de agentes no termina cuando el modelo produce una aplicación vistosa. Termina cuando puede demostrarse qué hizo, cuánto costó, qué entradas rechazó, qué acciones no pudo ejecutar y cómo se recuperó de un error. Grok 4.6 eleva el nivel de capacidad al que hay que hacer esas preguntas. Su tarjeta, leída entera, también explica por qué siguen siendo necesarias.
Fuentes
- SpaceXAI, Introducing Grok 4.6, 12 de agosto de 2026.
- SpaceXAI, Grok 4.6 Model Card, revisión del 12 de agosto de 2026.
- SpaceXAI, documentación de Grok 4.6, actualizada el 12 de agosto de 2026.
- Cursor, Introducing Grok 4.6 y CursorBench 3.2, 12 de agosto de 2026 y consulta del 14 de agosto.
- SpaceXAI, Frontier Artificial Intelligence Framework, 30 de junio de 2026.