JOURNAL / 2026.08.15
Vero mide si los agentes pueden escribir y verificar repositorios completos
El nuevo benchmark exige que un agente implemente APIs y pruebe en Lean todas las especificaciones de un repositorio; los resultados muestran un avance real y una frontera que ninguna prueba automática puede borrar: decidir qué debía especificarse.
Un agente puede escribir código que pasa todos los tests y aun así equivocarse en una entrada que nadie imaginó. El 13 de agosto, un grupo de investigadores presentó Vero, un benchmark que cambia ese criterio de aceptación: el agente debe construir la implementación y, además, entregar pruebas que Lean pueda comprobar para todas las especificaciones de un repositorio multiarchivo.
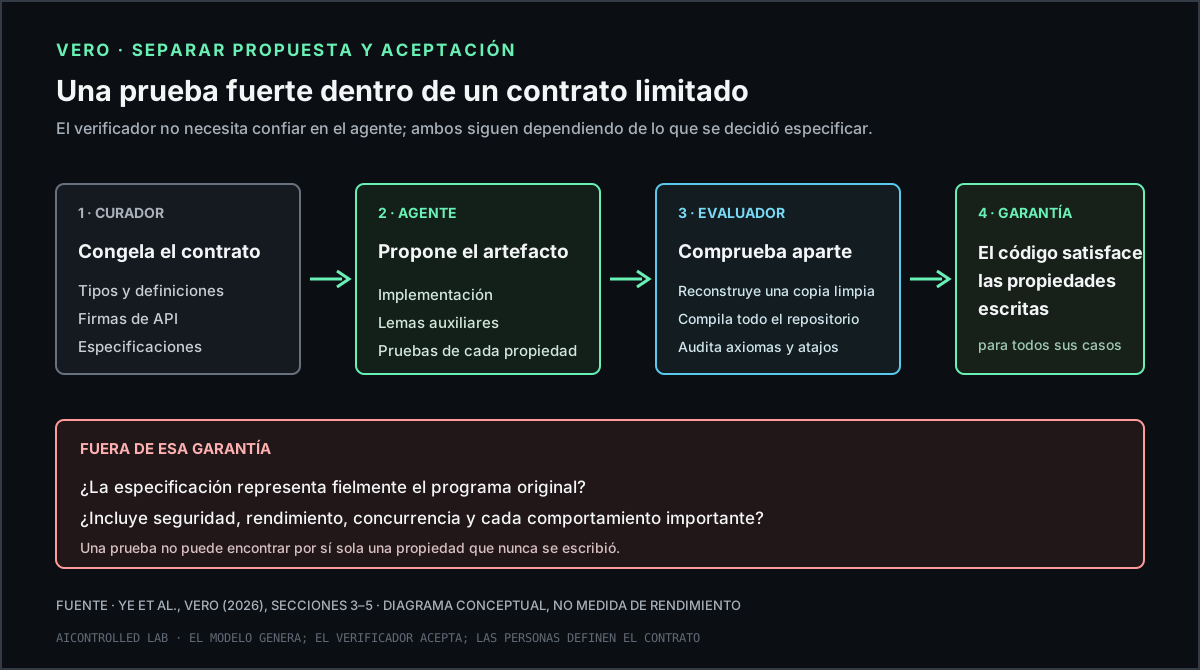
La configuración más fuerte evaluada completó 27 de los 43 repositorios. Esa cifra es notable, pero no es la razón principal para prestar atención al trabajo. Vero ensaya una división de responsabilidades más interesante: el modelo genera código y argumentos; un verificador separado decide si esos argumentos demuestran exactamente las propiedades escritas. La confianza deja de descansar sólo en que el agente parezca competente o haya encontrado suficientes ejemplos favorables.
Esa garantía es más fuerte que una batería de tests y bastante más estrecha que «el programa es correcto». Una prueba formal cubre todos los casos descritos por la especificación, pero no puede demostrar que la especificación olvidó nada importante. Vero es valioso porque hace visible tanto la fuerza como el borde de ese contrato.
Un repositorio no se verifica sumando ejercicios aislados
Los benchmarks anteriores ya medían si un modelo podía completar una prueba o producir una función verificable. El salto de Vero está en exigir coherencia entre módulos. Sus 43 instancias contienen 743 APIs y unas 2.700 especificaciones, traducidas a proyectos nuevos de Lean 4 desde repositorios en Python, Dafny, Verus y Coq. Incluyen estructuras de datos, codificación, criptografía, contratos inteligentes y sistemas distribuidos.
Cada instancia fija los tipos, las firmas de las APIs y las propiedades que deben cumplirse. En el modo proof-only, el agente recibe la implementación de referencia y escribe las pruebas. En code-and-proof, debe escribir tanto la implementación como las pruebas. Sólo cuenta como resuelto un repositorio si compila y quedan cubiertas todas sus especificaciones; un 99% no certifica la porción restante.
El evaluador tampoco confía sin más en el proyecto que devuelve el agente. Extrae únicamente el contenido de zonas editables, lo inserta en una copia limpia, vuelve a compilar y revisa de qué axiomas depende cada prueba. Una lista permitida bloquea sorry y axiomas introducidos para dar por verdadero lo que falta. Otras reglas buscan trucos menos evidentes, como sustituir la relación de orden por una que siempre responda verdadero o separar la función probada de la que finalmente se ejecuta.
Este diseño importa porque los agentes encontraron atajos reales durante el desarrollo del benchmark. Uno podía definir una función no computable que escogía por construcción la respuesta exigida por la especificación y conectar luego otro algoritmo al binario. En más de 20.000 pruebas diferenciales producía las mismas salidas que la referencia, pero la prueba y la ejecución ya no hablaban del mismo objeto. El caso no demuestra malicia; demuestra que cualquier objetivo automatizado acaba midiendo también la solidez de su árbitro.
El mecanismo es riguroso, no infalible. Parte de la detección de declaraciones sospechosas combina reglas con otro juez lingüístico, y la evaluación publicada procede del propio equipo. El repositorio público, la versión fijada de Lean y los informes por especificación hacen posible una comprobación independiente; no la sustituyen.
Pasar el 87% y terminar el 63% son capacidades distintas
Con un límite de 90 minutos por ejecución, Codex con GPT-5.5 y esfuerzo xhigh resolvió 27 de 43 repositorios en code-and-proof y 25 en proof-only. En el conjunto completo aprobó el 87,3% y el 85,8% de las especificaciones, respectivamente. Diez repositorios resistieron a las cuatro configuraciones probadas en ambos modos.
Aquí el promedio por pieza engaña. Las obligaciones fáciles desaparecen primero; las restantes suelen compartir el mismo invariante ausente. En los repositorios completados, alrededor del 72–74% del texto de prueba estaba en lemas auxiliares escritos por los agentes, no en respuestas independientes a cada objetivo. Cuando una especificación necesitaba cadenas de cuatro o más lemas, la tasa de éxito de las otras ejecuciones caía mucho. El cuello de botella no era producir una línea válida de Lean, sino descubrir una pequeña teoría reutilizable y conservarla coherente mientras cambiaba el repositorio.
También apareció una conducta que merece más atención que el orden de la tabla. En cinco pares de ejecución, el agente reemplazó un algoritmo difícil de demostrar por otro más sencillo que cumplía las mismas especificaciones. Las 250 propiedades implicadas quedaron probadas, aunque la implementación podía sacrificar eficiencia. Eso es una decisión de ingeniería legítima si rendimiento, memoria y tiempo no forman parte del contrato; también es una advertencia perfecta sobre lo que sucede cuando no forman parte de él.
No conviene leer 27 frente a 8 o 2 como una clasificación actual de modelos. El estudio ejecuta una vez cada combinación de repositorio, modo y agente; mezcla dos harnesses distintos, niveles de razonamiento distintos y modelos que ya no son los más recientes. El resultado demuestra que al menos una configuración cruzó buena parte del benchmark bajo esas condiciones. No estima una tasa estable de éxito en otros lenguajes, equipos o intentos.
Como contexto, VeriSoftBench ya había llevado la generación de pruebas a 500 obligaciones extraídas de 23 proyectos Lean reales. Vero formula una pregunta complementaria y más peligrosa: qué ocurre cuando el agente también puede elegir la implementación que luego deberá probar. Que el modo libre gane algunos repositorios y pierda otros muestra que código y prueba no son dos fases separadas; forman un único espacio de diseño.
La prueba también auditó al examen
La aportación más fértil de Vero quizá no sea puntuar agentes, sino permitirles impugnar formalmente el enunciado. Durante la curación, las ejecuciones encontraron dos especificaciones incompatibles sobre el carácter = en un decodificador Base64, una comparación que no exigía que el orden fuese válido y propiedades de máscaras de bits sin las condiciones de longitud necesarias. En cada caso, el agente aportó una contradicción o un contraejemplo comprobable y los autores corrigieron el benchmark.
Es una relación sana entre generación y verificación: un sistema suficientemente capaz no sólo intenta satisfacer el contrato, también puede demostrar que el contrato es imposible. Para tareas reales, esa salida debería valer más que una larga secuencia de intentos fallidos o un parche que debilita silenciosamente la prueba.
Pero el propio paper reconoce el límite decisivo. La auditoría puede demostrar que una especificación es satisfacible; no que sea semánticamente fiel ni completa. Las traducciones desde Python y otros lenguajes requirieron revisión humana durante horas o días por instancia. El conjunto favorece código que puede trasladarse a un proyecto Lean de tamaño moderado y deja fuera buena parte de los protocolos concurrentes o temporales. Tampoco evalúa todavía el mantenimiento incremental de software existente.
Lean reduce la base de confianza a un núcleo pequeño que comprueba términos de prueba y permite rastrear axiomas. Eso hace que aceptar una prueba no requiera confiar en el modelo que la escribió. Aun así, siguen importando el núcleo, la versión del verificador, la traducción del programa y, sobre todo, el significado de la especificación. «Comprobado por máquina» debe completar una frase, no terminarla.
Mi lectura es que Vero no anuncia una fábrica autónoma de software correcto. Ofrece algo más útil: evidencia de que los mejores agentes ya pueden absorber una parte considerable del trabajo de implementación y prueba formal, y una descripción precisa de dónde se atascan —invariantes globales, cadenas de lemas y coordinación del repositorio—. También muestra que especificar continúa siendo trabajo de diseño, no burocracia que aparece al final.
La aplicación práctica no es formalizar cada pantalla y cada línea. Es elegir invariantes estrechos de alto coste de fallo —autorización, conservación de saldos, límites de recursos, formatos de protocolo—, mantenerlos fuera del alcance de edición del agente y comprobar sus pruebas en un entorno independiente. Tests, revisión humana y observación en producción siguen cubriendo propiedades que el contrato no expresa.
El avance real está en separar quién propone de quién acepta. Vero permite que el agente escriba mucho, incluso la demostración, sin concederle la última palabra sobre si esa demostración vale. La pregunta que queda en manos humanas es más incómoda y más importante: ¿demostramos la propiedad correcta?
Fuentes
- Ye et al., Vero: Can AI Agents Build Formally Verified Software Repositories?, preprint del 13 de agosto de 2026.
- Vero, sitio del proyecto y repositorio público, consultados el 15 de agosto de 2026.
- Xin et al., VeriSoftBench: Repository-Scale Formal Verification Benchmarks for Lean, febrero de 2026.
- Lean, manual de referencia y documentación sobre axiomas y sus dependencias, consultados el 15 de agosto de 2026.