JOURNAL / 2026.08.17
Intern-S2-Mobius comparte la memoria del modelo y acorta su razonamiento visible
Shanghai AI Laboratory publica una arquitectura que sustituye memorias ligadas a cada capa por un almacén compartido; los pesos permiten probarla, pero su «casi 4×» es una medida extremo a extremo dominada por respuestas más cortas.
La mayoría de las mejoras de inferencia intentan ejecutar más deprisa el mismo modelo: mejores kernels, cuantización, cachés o predicción especulativa. Intern-S2-Mobius, presentado por Shanghai AI Laboratory, hace una apuesta distinta. Reorganiza dónde guarda conocimiento el modelo y deja que varios bloques de razonamiento consulten una memoria común. El objetivo no es abaratar cada operación, sino necesitar menos operaciones secuenciales y menos texto intermedio para llegar a una respuesta.
El lanzamiento merece atención porque no se queda en un dibujo. Hay un checkpoint de 35.000 millones de parámetros sin barrera de acceso, con licencia Apache 2.0, configuración y código personalizado de inferencia. Sus cinco fragmentos BF16 suman unos 68 GiB. Es un artefacto que otros pueden ejecutar e inspeccionar, no sólo una promesa de arquitectura.
También exige leer con cuidado su afirmación principal. «Casi cuatro veces más rápido» suena a que Mobius procesa cada token a una cuarta parte del coste. Los datos publicados no demuestran eso. Miden solicitudes terminadas por segundo y la mayor parte de la ventaja procede de que el modelo genera cadenas de razonamiento mucho más cortas. Esa puede ser una mejora más importante que acelerar un kernel, pero es otra mejora y necesita otras pruebas.
Una memoria para varios razonadores
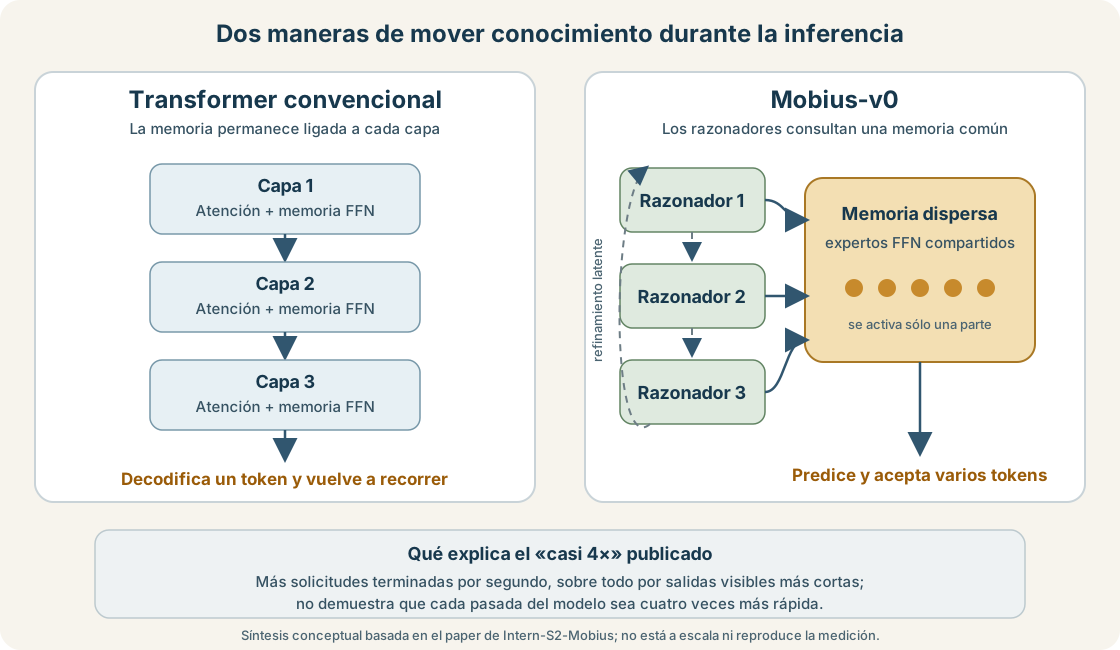
En un Transformer convencional, cada capa combina atención —que relaciona elementos del contexto— con una red feed-forward que suele interpretarse como parte del almacén de conocimiento. La información avanza por esa sucesión. Si una respuesta requiere volver a combinar algo que no se activó a tiempo, el modelo puede usar nuevos tokens como otra vuelta por todas las capas.
Mobius desacopla esas funciones. Reúne los expertos feed-forward en una memoria global dispersa y hace que varios «razonadores», construidos con atención, la consulten mientras refinan estados ocultos recurrentes. No significa que la memoria contenga fichas legibles ni que la atención sea razonamiento en sentido humano. Es una descripción funcional de matrices aprendidas. La novedad está en que el conocimiento ya no queda atado a una única posición de la pila y el estado latente puede iterar antes de decodificar varios tokens.
El modelo publicado no nació desde cero. El equipo convirtió Qwen3.5-35B-A3B —un modelo disperso que activa alrededor de 3.000 millones de sus 35.000 millones de parámetros por token—, continuó su preentrenamiento y aplicó ajuste supervisado y aprendizaje por refuerzo. Eso hace posible probar la idea a una escala útil, pero complica atribuir las diferencias exclusivamente a la arquitectura: también cambiaron los datos y el postentrenamiento.
Los autores incluyen un experimento más controlado con dos modelos de 7.000 millones entrenados desde cero. Mobius alcanzó la puntuación final del Transformer en MMLU usando el 62,6% de sus datos. Es una señal interesante de compresión, no todavía una ley de eficiencia de datos. Un único benchmark de conocimiento general no dice si se conservaron por igual lenguaje, código, robustez o capacidades menos fáciles de puntuar.
El 4× es un resultado de extremo a extremo
En nueve evaluaciones generales, Intern-S2-Mobius obtiene una media declarada de 67,88 frente a 65,05 para Qwen3.5-35B. Gana siete, pero pierde en UGD hard y Humanity's Last Exam. En tres conjuntos científicos la ventaja es mucho mayor; como no hay una ablación que separe arquitectura, preentrenamiento continuo y postentrenamiento, esas cifras no prueban que compartir memoria sea su causa.
La gráfica de rendimiento aporta el matiz decisivo. Promediando cinco benchmarks de razonamiento, Mobius completa 2,9 veces más solicitudes por segundo con un lote de 16 y 4,6 veces más con un lote de 256. En algunos conjuntos la ventaja crece mucho con el lote; en otros, el Transformer conserva ventaja en ciertos puntos. El propio paper reconoce que acceder a la gran memoria dispersa añade presión y hace menos eficiente cada pasada. El balance mejora porque Mobius produce menos tokens visibles y porque su cabeza de predicción múltiple puede aceptar varios de una vez.
Faltan datos para trasladar ese resultado. El informe no identifica junto a la prueba el hardware, el motor de servicio, la versión del software, las longitudes de entrada, el uso exacto de predicción especulativa ni una distribución de latencia. Tampoco publica las configuraciones de OpenCompass empleadas. Sin esos elementos, «4×» no es todavía un presupuesto de capacidad para un despliegue ni una comparación independiente.
La brevedad introduce otra pregunta. En los dos ejemplos desglosados, Mobius llega a la misma respuesta correcta evitando comprobaciones repetidas. Pero dos casos no muestran si elimina redundancia inútil o pasos que detectaban errores en problemas más difíciles. Los propios autores dicen que el mecanismo exacto no está establecido. Haría falta comparar a igual calidad sobre muchos intentos, medir colas de latencia y coste energético, y buscar fallos que aumenten cuando el razonamiento visible se comprime.
Lo abierto permite formular una prueba mejor
Hoy se puede descargar el núcleo del modelo y servirlo con Transformers, LMDeploy, vLLM o SGLang. La configuración declara contexto nativo de 262.144 posiciones y una torre visual, aunque el paper sólo aporta resultados de texto y ciencia; no demuestra aquí una nueva capacidad multimodal. Tampoco es un modelo pequeño: los pesos BF16 ocupan casi 68 GiB antes de cachés y memoria de ejecución, y el repositorio no ofrece todavía una cuantización oficial.
La guía requiere trust_remote_code, una señal práctica para revisar y fijar el código antes de ejecutarlo. El repositorio del proyecto contiene por ahora documentación y ejemplos, mientras el checkpoint aloja la implementación del modelo. No están publicados el conjunto de entrenamiento, la receta completa, los logs ni el código que permitiría repetir la conversión y el entrenamiento. «Pesos abiertos» permite evaluar el resultado; no reproduce automáticamente el camino hasta él.
Mi lectura es que la contribución más interesante no es una nueva cima de benchmark. Es convertir el razonamiento latente —explorado antes por trabajos como COCONUT— en una arquitectura de tamaño práctico y entregar el artefacto. Si laboratorios independientes reproducen la calidad y la ventaja de extremo a extremo, el coste de razonar dejaría de depender tanto de una larga transcripción token a token. Eso cambiaría el diseño de servicios: importaría tanto cuántos tokens evita el modelo como la velocidad con que genera cada uno.
El intercambio no es gratuito. Un rastro más corto cuesta menos y puede contener menos teatro explicativo, pero también ofrece menos superficie para inspeccionar por qué falló. Las cadenas de pensamiento nunca fueron una auditoría fiel del estado interno; ocultarlas aún más obliga a evaluar resultados, calibración y comportamiento bajo variaciones, no a confundir una explicación fluida con evidencia.
Mobius ha hecho verificable la pregunta arquitectónica, no la respuesta industrial. El siguiente paso útil es sencillo de formular y difícil de ejecutar: mismo hardware, mismo motor, mismas preguntas, igual tasa de acierto y distribución completa de latencia. Si la ventaja sobrevive a esa prueba, «pensar menos en voz alta» habrá dejado de ser una preferencia de estilo para convertirse en una mejora material de infraestructura.
Fuentes
- Intern-S2-Mobius Team, Intern-S2-Mobius: Foundation Model with Decoupled Knowledge and Reasoning, preprint enviado el 14 de agosto de 2026.
- Shanghai AI Laboratory, checkpoint, configuración y tarjeta de Intern-S2-Mobius, consultados el 17 de agosto de 2026.
- InternLM, repositorio de Intern-S2-Mobius, consultado el 17 de agosto de 2026.
- Qwen, tarjeta del modelo Qwen3.5-35B-A3B, modelo de partida y referencia Transformer.
- Hao et al., Training Large Language Models to Reason in a Continuous Latent Space, trabajo COCONUT sobre razonamiento latente continuo.