JOURNAL / 2026.08.19
GLM-5.3 mejora en ciberseguridad, pero Z.ai retrasa sus pesos
El nuevo modelo ya funciona por API y avanza con fuerza desde la detección de fallos hacia la explotación; Z.ai promete los pesos tras dos semanas de revisión, sin publicar todavía el criterio que decidirá si están listos.
Z.ai ha hecho dos lanzamientos con una sola fecha. Desde el 14 de agosto, GLM-5.3 puede usarse mediante su API y su plan para agentes de código. Los pesos, en cambio, llegarán «dos semanas después del lanzamiento», una vez terminadas la evaluación de seguridad y las medidas de refuerzo. A fecha de hoy no aparecen en la organización oficial de Z.ai en Hugging Face.
La separación importa porque la capacidad ya está circulando, pero todavía bajo el control del proveedor. Un equipo puede incorporar el modelo a un agente, darle terminal y herramientas y enviarle código real. No puede aún ejecutarlo sin conexión, inspeccionar el artefacto publicado, modificar sus salvaguardas ni comprobar si el servicio y el futuro checkpoint se comportan igual.
El motivo declarado del retraso es también la novedad principal. Z.ai entrenó deliberadamente el modelo con datos y entornos de descubrimiento de vulnerabilidades. La mejora fue mayor de lo esperado al avanzar desde localizar fallos hacia construir cadenas de explotación, y la empresa la llama «capacidad cibernética emergente». Hay evidencia de un salto importante respecto a GLM-5.2. No hay evidencia de que haya superado de forma general a los modelos cerrados de frontera, y «emergente» no significa que la habilidad apareciera sin entrenamiento.
El mismo modelo base aprendió un trabajo distinto
Según la documentación técnica de GLM-5.3, la base es la misma que la de GLM-5.2: todo el avance procede del postentrenamiento. Z.ai amplió los entornos ejecutables de aprendizaje por refuerzo para representar unidades de trabajo más largas. Un ejemplo interno da al agente código, documentación, almacenamiento, resultados experimentales y acceso a cómputo; debe encontrar un cuello de botella, cambiar el sistema, ejecutar pruebas y demostrar una mejora sin romper la corrección.
El mecanismo para crear esas prácticas también usa agentes. Unos extraen patrones de trabajos reales y sintetizan entornos con estado oculto; otro intenta resolverlos; los verificadores se generan sin ver la solución de referencia y se prueban contra respuestas correctas, estados sin resolver y acciones nulas. El método busca escalar algo valioso: tareas que se puedan ejecutar y calificar, no sólo respuestas que otro modelo considere plausibles. Z.ai reconoce que todavía requiere una intervención humana significativa y no publica los entornos privados ni una medida de cuántos verificadores defectuosos se descartaron.
En el banco privado Z.ai Code Bench, la configuración de esfuerzo máximo pasa del 23,4% con GLM-5.2 al 34,5% con GLM-5.3 mientras reduce la salida aproximada por tarea de 96.000 a 75.000 tokens. De ahí procede el «50% mejor» del anuncio: es una mejora relativa en una evaluación interna, no cincuenta puntos ni una aceleración garantizada en cualquier repositorio. Las pruebas públicas de terminal y agentes también se mueven en la misma dirección, pero sus resultados dependen del harness, el presupuesto y la versión exacta del conjunto.
Para quien construye hoy, el cambio es concreto. GLM-5.3 acepta sólo texto, tiene un contexto anunciado de un millón de tokens, puede producir hasta 128.000 y mantiene el razonamiento siempre activado con tres niveles de esfuerzo. La tarifa de la API conserva los 1,40 dólares por millón de tokens de entrada y 4,40 por millón de salida de GLM-5.2. Un contexto grande permite cargar más estado; no demuestra que el modelo lo use bien durante todo el recorrido, y el coste por tarea seguirá incluyendo herramientas, reintentos y revisión.
Detectar, desarrollar y completar un ataque no son la misma prueba
La cifra que más se ha difundido es 84,5% en CyberGym, ligeramente por encima del 83,8% que Z.ai atribuye a Mythos 5 y del 83,6% de GPT-5.6 Sol. CyberGym parte de código fuente y descripciones de vulnerabilidades reales; el agente debe producir una prueba que active el fallo. Es una medida útil de reproducción y validación en caja blanca. No equivale a descubrir un fallo desconocido en cualquier proyecto ni a convertirlo en acceso arbitrario.
Las otras dos pruebas del propio anuncio impiden el titular cómodo de que GLM-5.3 «vence a la frontera». En ExploitBench, que parte de un parche conocido y puntúa peldaños desde alcanzar el código vulnerable hasta ejecutar código arbitrario, GLM-5.3 obtiene un 54,4%. Es más del doble del 24,4% de GLM-5.2, pero queda por detrás del 78,0% atribuido a Mythos 5 y del 76,5% de GPT-5.6 Sol. En ExploitGym completa 130 tareas con un presupuesto normalizado de seis horas, frente a 39 de la versión anterior y 247 de Mythos 5.
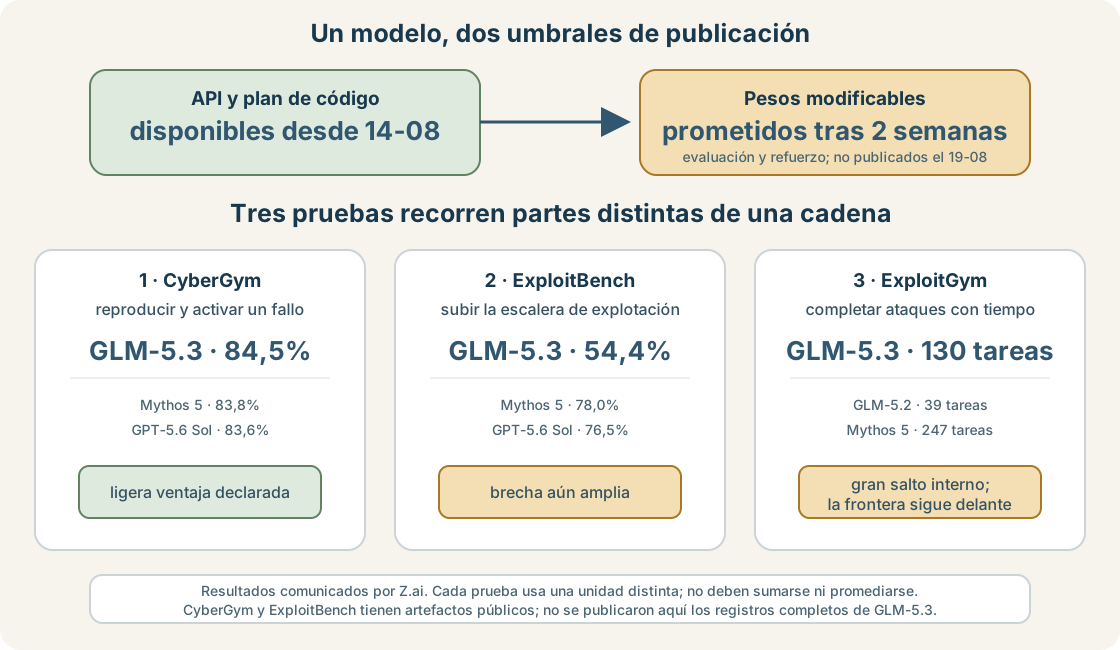
Las escalas no se pueden promediar: una es porcentaje de vulnerabilidades reproducidas, otra es una puntuación de progreso dentro de una cadena y la tercera cuenta tareas bajo tiempo normalizado. Tampoco son resultados independientes; Z.ai ejecutó o recopiló las comparaciones y no ha publicado junto al anuncio los registros completos de GLM-5.3. Lo que sí se repite entre pruebas es una dirección: el postentrenamiento produjo un salto especialmente grande en explotación más profunda, aunque allí siga existiendo una brecha considerable.
Ese patrón justifica evaluar antes de entregar un artefacto modificable. No justifica por sí solo cualquier conclusión sobre uso malicioso real. Una capacidad puede servir para encontrar, reproducir y corregir fallos o para explotarlos; la diferencia la ponen el objetivo, la información, las herramientas, los permisos y la supervisión. El servicio actual conserva un punto donde Z.ai puede observar abuso, limitar cuentas o retirar una versión. Los pesos reducirán ese control y, a la vez, permitirán evaluación independiente, ejecución aislada y adaptación defensiva que una API puede impedir.
Un registro público abre la puerta, pero sólo un poco
Z.ai acompaña el lanzamiento con un registro de divulgación de vulnerabilidades. Afirma que sus modelos, trabajando con varios equipos de seguridad y después de revisión experta y deduplicación, encontraron 2.436 fallos en 269 proyectos. El registro clasificaba el 19 de agosto 107 como críticos y 990 como altos. Es evidencia más útil que una cifra sin objetos: las entradas ya divulgadas pueden enlazar proyecto, antigüedad, severidad y CVE.
Pero el propio contador delimita la afirmación. Sólo 53 hallazgos figuraban como públicos y 2.383 seguían sin divulgarse. Esa reserva puede ser correcta durante una notificación responsable; también significa que el público no puede auditar todavía la gran mayoría, comprobar cuántos aceptaron los mantenedores, distinguir fallos nuevos de variantes ni estimar falsos positivos. El total es por ahora un resultado atribuido con una pequeña muestra verificable, no 2.436 confirmaciones externas.
Mi lectura es que el lanzamiento escalonado es una respuesta razonable a una capacidad de doble uso que avanzó deprisa. Es mejor conservar temporalmente un punto de control que publicar por inercia porque la generación anterior tenía pesos abiertos. Sin embargo, «dos semanas de seguridad» sólo será una política y no una pausa promocional si Z.ai explica qué amenazas evalúa, quién revisa, qué resultado permitiría publicar, qué medidas pueden sobrevivir a una modificación de los pesos y qué haría aplazar de nuevo la fecha.
La decisión no termina cuando aparezcan los archivos. Entonces empezará una prueba más exigente: si los resultados se reproducen con un harness público, si el checkpoint coincide en lo sustantivo con el servicio y si el registro convierte sus miles de afirmaciones en divulgaciones que los proyectos afectados reconocen. Hasta entonces conviene sostener dos ideas a la vez. GLM-5.3 parece un avance material en agentes de código y ciberseguridad. Su mejor resultado no borra la distancia en explotación profunda, y la promesa de pesos no equivale todavía a una publicación abierta.
Fuentes
- Z.ai, GLM-5.3: Frontier Coding with Emergent Cyber Capabilities, 14 de agosto de 2026.
- Z.ai, documentación de GLM-5.3, guía de migración y precios de la API, consultados el 19 de agosto de 2026.
- Z.ai, Security Disclosure Ledger, consultado el 19 de agosto de 2026.
- Wang et al., CyberGym: Evaluating AI Agents’ Cybersecurity Capabilities with Real-World Vulnerabilities at Scale, ICLR 2026.
- Lee y Brumley, ExploitBench: A Capability Ladder Benchmark for LLM Cybersecurity Agents, preprint y artefactos públicos de 2026.