JOURNAL / 2026.08.21
Claude diseña 354 proteínas de unión validadas en laboratorio
Claude dirigió campañas de diseño contra 16 objetivos y dos laboratorios midieron todos los candidatos; el resultado demuestra unión molecular, no función ni un fármaco terminado.
Un modelo de lenguaje ya no sólo propone una proteína en una pantalla. En un experimento publicado por Anthropic, Claude dirigió campañas de diseño contra 16 objetivos, entregó 30 candidatos por objetivo y dejó que la síntesis y la medición física decidieran el resultado. De los 1.320 diseños con datos interpretables, 354 se unieron a su objetivo. Hubo al menos un éxito en 14 de los 15 objetivos que pudieron evaluarse.
Es una evidencia inusualmente concreta para una afirmación sobre «IA para la ciencia». También es fácil contarla mal. Claude no generó las proteínas desde sus propios parámetros, no inventó por sí solo el protocolo y no produjo 354 medicamentos. La contribución está en otro lugar: un agente general coordinó herramientas especializadas, sostuvo decisiones durante uno o dos días y entregó una cartera completa a un laboratorio sin que una persona eligiera los candidatos favorables después de ver el resultado.
El sistema era más grande que Claude
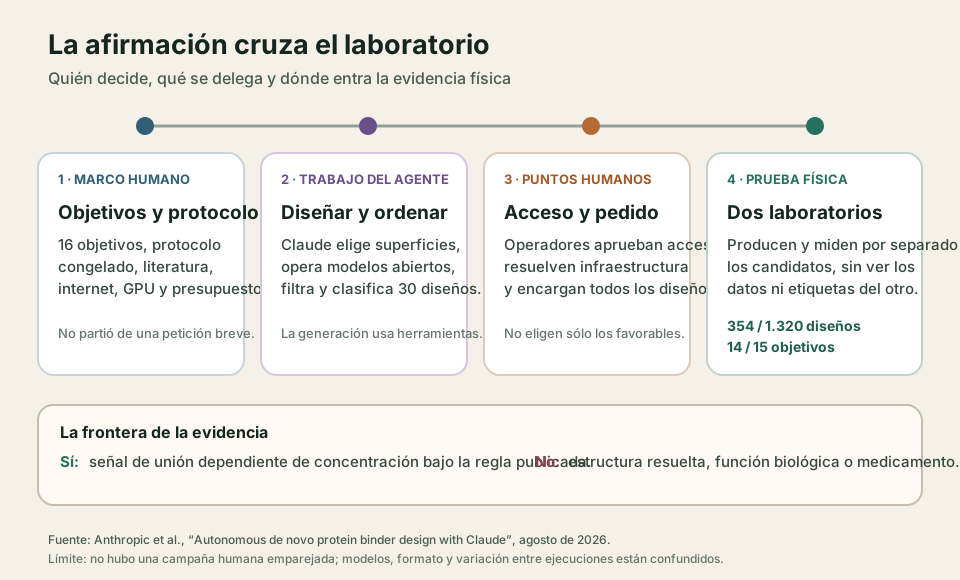
Los investigadores eligieron los objetivos y escribieron un protocolo de unos 30.000 tokens. Lo ajustaron en campañas de prueba y lo congelaron antes de los experimentos informados. También proporcionaron literatura, internet, conectores, acceso a GPU y presupuestos de hasta 50.000 dólares para una campaña multiobjetivo de 48 horas o 10.000 para una campaña de 24 horas dedicada a un solo objetivo.
Dentro de ese marco, Claude Opus 4.8 y un modelo no publicado llamado Mythos Preview investigaron cada proteína objetivo, eligieron la zona a la que intentar unirse, instalaron y ejecutaron modelos abiertos de diseño estructural, diseño de secuencias y plegamiento conjunto, repitieron filtros y optimizaciones y ordenaron los 30 candidatos finales. Los operadores humanos aprobaron solicitudes de acceso, resolvieron fallos de infraestructura y encargaron la síntesis, pero no instalaron las herramientas, escogieron las superficies de unión ni cambiaron la clasificación final.
Ése es el cambio práctico. Los modelos especializados capaces de proponer y puntuar estructuras ya existían. El nuevo trabajo prueba que un modelo general puede convertirlos en una campaña larga y coherente sin que un especialista conduzca cada paso. No elimina la experiencia: parte de ella está comprimida en el protocolo, el corpus y las herramientas. Sí desplaza el cuello de botella desde saber manejar toda la pila computacional hacia formular el objetivo, revisar el proceso y pagar la verificación física.
La medición física cambia la calidad de la afirmación
Anthropic no ensayó sólo una selección prometedora. Dos organizaciones de investigación por contrato, Adaptyv Bio y Twist Bioscience, recibieron todos los diseños entregados. Los produjeron y midieron por separado mediante formatos distintos de resonancia de plasmones superficiales. Ninguna veía los datos de la otra ni sabía qué modelo, campaña o posición en la clasificación había producido una secuencia.
Un objetivo generó agregación y mediciones inespecíficas en ambos laboratorios; sus 120 candidatos fueron excluidos y quedaron 1.320. Para integrar las dos lecturas, los autores aplicaron una regla fija y publicaron las señales crudas, los ajustes y las etiquetas. El recuento de 354 corresponde a candidatos con una señal de unión dependiente de la concentración en uno o ambos laboratorios bajo esa regla. No es una puntuación simulada. En el extremo difícil, ninguno de los 90 diseños contra la proteína de unión a maltosa fue confirmado; el fracaso también está en el conjunto público.
Esa exhaustividad importa más que el titular comparativo. Anthropic señala una tasa total del 26,8% y la contrasta con campañas anteriores, pero el informe técnico reconoce que no hubo un equipo humano trabajando con los mismos objetivos, herramientas y presupuesto. Los resultados de cuatro de las seis competiciones usadas para comparar ya estaban disponibles durante el diseño. Además, el modo dedicado asignó 2,8 veces más cómputo por objetivo que el multiobjetivo, de modo que no permite separar el efecto de la concentración del efecto del presupuesto. Las tasas de acierto tampoco son plenamente comparables entre publicaciones: Adaptyv explica que cambian los objetivos, los ensayos y hasta la definición de «unión».
Por eso la afirmación sólida no es que Claude haya vencido a los mejores diseñadores humanos. Es que ejecutó autónomamente, a una escala poco habitual, un proceso completo cuyos resultados fueron sometidos a una prueba física ciega y exhaustiva. El conjunto publicado contiene los protocolos, la procedencia por diseño, las secuencias, predicciones estructurales y las mediciones de laboratorio bajo licencias abiertas. Permite auditar el recuento y mejorar los filtros, aunque no reproduce exactamente al agente porque Mythos Preview y el entorno Claude Science no están disponibles de forma general.
Unirse no es funcionar
La frontera más importante está después del experimento. Ninguna de estas proteínas fue probada por su actividad biológica y ninguna estructura se resolvió experimentalmente. En cinco objetivos oligoméricos, la multivalencia puede reforzar la afinidad aparente. Varias secuencias proceden además de un mismo esqueleto y no son intentos totalmente independientes. Los propios autores reducen la tasa del 26,8% al 24,7% cuando conservan sólo la secuencia mejor clasificada de cada esqueleto.
Una proteína que se une es un punto de partida, no un tratamiento. Todavía habría que confirmar dónde y cómo se une, demostrar que produce el efecto biológico buscado, estudiar selectividad, estabilidad, inmunogenicidad, distribución y toxicidad, y después recorrer desarrollo preclínico y ensayos clínicos. El resultado puede acortar una etapa temprana que consume semanas de trabajo computacional. No autoriza a comprimir el resto de la cadena en la palabra «fármaco».
Tampoco es hoy una capacidad lista para cualquier desarrollador. Anthropic mantiene las consultas de diseño molecular profesional fuera del acceso general de su modelo Fable 5 y las deriva a un modelo menos capaz mientras prepara vías de acceso confiable, según su política de salvaguardas biológicas. Aun con el agente, hacen falta cómputo especializado, síntesis y ensayos. Esos pasos son coste, pero también puntos de control donde pueden revisarse objetivos, pedidos y resultados.
Mi lectura es que la parte más importante no son los 354 éxitos aislados, sino la unión entre autonomía digital y verificación material. Muchos agentes parecen convincentes porque el mismo entorno que genera su trabajo también lo califica. Aquí las moléculas tuvieron que existir y producir una señal física, y todos los intentos llegaron al marcador. Ése es un estándar que la IA científica debería imitar.
El mismo diseño experimental también muestra dónde concentrar la prudencia. Si los modelos generales aprenden a manejar herramientas científicas existentes, evaluar sólo lo que saben responder en texto dejará de describir su capacidad real. Habrá que evaluar el sistema con sus herramientas, presupuesto y acceso, conservar controles humanos sobre la ejecución física y publicar tanto los fracasos como los éxitos. Este trabajo no demuestra una fábrica autónoma de medicamentos. Demuestra algo anterior y suficientemente importante: una parte especializada del diseño molecular ya puede convertirse en trabajo delegable, medible y mucho más rápido.
Fuentes
- Anthropic, How Claude is accelerating protein design and analytical chemistry, 18 de agosto de 2026.
- Anthropic et al., Autonomous de novo protein binder design with Claude, informe técnico, agosto de 2026.
- Anthropic, protocolos, diseños y datos experimentales de la campaña, consultados el 21 de agosto de 2026.
- Anthropic, Improving Fable 5's biology safeguards, 7 de agosto de 2026.
- Adaptyv Bio, Introducing BenchBB and the community paper of the Protein Design Competition, 26 de abril de 2025.