JOURNAL / 2026.08.25
Thomson Reuters lanza Thomson, un modelo jurídico construido sobre Qwen
La empresa especializó pesos abiertos con datos y expertos propios y publica una versión pequeña; el resultado vuelve plausible otra economía para los modelos verticales, aunque «frontera» y «soberanía» necesitan matices.
Thomson Reuters no ha entrenado un modelo desde cero para competir con los grandes laboratorios. Ha hecho algo más interesante para muchas organizaciones: tomar un buen modelo con pesos abiertos, modificar todos sus parámetros con datos y evaluadores propios y convertirlo en un sistema que controla de extremo a extremo.
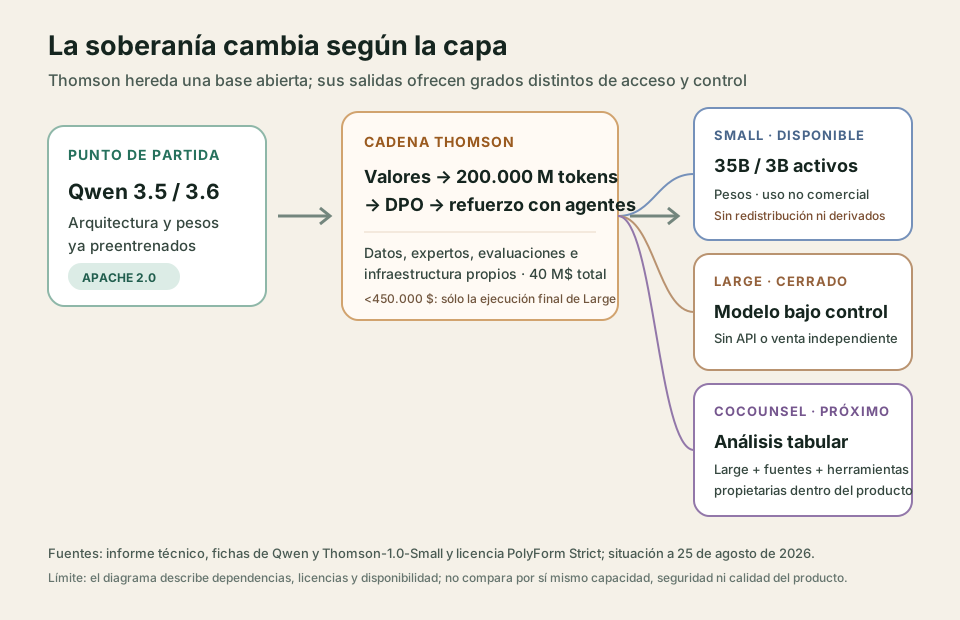
El 24 de agosto la empresa presentó Thomson, una familia especializada en trabajo jurídico, fiscal y periodístico. Thomson-1.0-Large parte de Qwen3.5-397B-A17B; una versión de 35.000 millones de parámetros —3.000 millones activos por token— parte de Qwen3.6-35B-A3B y ya tiene sus pesos disponibles. El modelo grande no se ofrece por API ni se vende por separado: su primer uso previsto está dentro del análisis tabular de CoCounsel Legal, en una próxima versión del producto.
La noticia no es, por tanto, que haya aparecido otro chatbot general. Es una demostración bastante detallada de una posible fábrica de modelos verticales. También es una demostración producida por la propia empresa, con una palabra —«frontera»— mucho más ancha que la evidencia que la acompaña.
El coste importante no es sólo el entrenamiento final
El informe técnico de 121 páginas describe tres módulos. Primero, Thomson Reuters reajustó valores mediante preferencias derivadas de una constitución pública. Después hizo entrenamiento continuo sobre 200.000 millones de tokens seleccionados de un fondo de más de 19 billones: aproximadamente un tercio eran documentos propietarios, otro tercio reformulaciones sintéticas de esos documentos y el resto datos generales de repaso. Una fusión con el checkpoint anterior intentó recuperar capacidades que esa especialización podía borrar. Por último llegaron dos etapas de optimización de preferencias y dos de aprendizaje por refuerzo, incluida la práctica de búsquedas largas con herramientas y recompensas por citar fielmente.
Esto es bastante más que añadir documentos a una consulta o ajustar un adaptador pequeño. Son actualizaciones completas de pesos, una cadena propia de generación y trazabilidad de datos, entornos de agentes, evaluaciones y servicio de inferencia. El modelo hereda arquitectura y una enorme inversión previa de Qwen, pero absorbe conocimiento y comportamiento nuevos dentro de sus parámetros.
Las cifras ayudan a no confundir dos historias de coste. El entrenamiento final de Large duró tres semanas y la empresa estima que consumió menos de 450.000 dólares en GPU. El proyecto completo costó unos 40 millones, incluyendo personal, expertos de dominio, proveedores, infraestructura reutilizable y experimentación. Trabajó en él un equipo técnico de no más de tres docenas de personas y llegó a disponer de 368 GPU B200 en algún momento, aunque las etapas principales de Large usaron 128 a la vez.
Por eso no sería honesto titular que un modelo frontera cuesta 450.000 dólares. Lo que muestra Thomson es otra cosa: una institución que ya posee contenido, especialistas, productos y una plataforma de cómputo puede evitar el preentrenamiento y concentrar decenas de millones en transformar un checkpoint abierto. Es mucho menos que fundar un laboratorio generalista; sigue estando lejos del alcance de una empresa pequeña.
Qué sostienen realmente las evaluaciones
Thomson Reuters calcula una media no ponderada sobre su amplia batería y sitúa a Large en 78,5%, cerca del 79,5% de Claude Opus 4.8 y por encima de varios modelos generales recientes. La comparación usa el mismo arnés, las mismas instrucciones y herramientas equivalentes cuando la tarea las permite. Además, Thomson mejora con claridad sobre su punto de partida Qwen en trabajo documental, consultas jurídicas humanas y agentes de investigación.
Esa media no convierte automáticamente a Thomson en el segundo mejor modelo general. Mezcla más de cien pruebas públicas e internas, concede el mismo peso a categorías muy distintas y usa jueces de lenguaje en muchas respuestas abiertas. Parte del material interno procede de los mismos dominios y expertos que orientaron el desarrollo. En programación, que no era objetivo, Large queda por debajo de varios rivales y el propio informe registra una caída de 54,0 a 48,3 entre Qwen y Thomson en Terminal-Bench 2.1. En PRBench, una prueba externa difícil de razonamiento profesional, su ventaja jurídica es pequeña y no domina todos los exámenes legales públicos.
El estudio humano aporta una señal diferente y más práctica. Treinta y cinco editores jurídicos formularon 3.035 tareas reales y compararon a ciegas respuestas emparejadas. Thomson, conectado a bases legales y a noticias de Reuters, fue preferido en el 54–64% de las consultas jurídicas frente a cada uno de cinco sistemas de OpenAI y Anthropic con búsqueda web. La ventaja apareció sobre todo en completitud y utilidad; la solidez jurídica fue parecida. En preguntas generales el resultado se estrechó, y GPT-5.6 Terra superó a Thomson en varias dimensiones.
Es una buena evaluación del producto que una editorial jurídica puede construir con su modelo y sus fuentes. No aísla la inteligencia del modelo: los rivales no accedían a las mismas bases de pago y los evaluadores trabajaban para Thomson Reuters. El informe lo reconoce y presenta el ejercicio como comparación de sistemas. Hace falta ahora una evaluación independiente del modelo grande, con herramientas controladas y conjuntos que el equipo no haya usado para decidir su desarrollo.
Soberanía para quién
La versión pequeña permite una comprobación que el modelo grande todavía no ofrece. Sus dieciséis archivos de pesos están publicados, su ficha explica la arquitectura, los 262.144 tokens de contexto y el cómputo de entrenamiento, y puede ejecutarse con herramientas habituales. Eso vuelve «pesos abiertos» una descripción verificable, no una promesa futura.
Pero no equivale a código abierto ni a libertad comercial. Qwen3.5, el cimiento de Large, se distribuye con Apache 2.0. Thomson-1.0-Small usa PolyForm Strict: permite fines no comerciales y el uso por organizaciones educativas, públicas o benéficas, pero no autoriza redistribuir los pesos ni crear obras derivadas. Large permanece cerrado y sólo Thomson Reuters decide dónde se ejecuta. La empresa ha ganado margen para cambiar proveedor, ciclo de actualización y política de datos gracias a un modelo abierto aguas arriba; no entrega el mismo margen a un competidor comercial aguas abajo.
Esa asimetría es legal y estratégicamente comprensible, pero limita la tesis de «IA soberana». Soberanía aquí significa que una institución controla una parte mayor de su propia cadena, no que desaparezcan sus dependencias ni que el resultado se convierta en un bien común. Siguen Qwen, las GPU de NVIDIA, proveedores de nube, datos con derechos y herramientas propietarias.
Mi lectura es que ahí está precisamente la importancia del lanzamiento. No prueba que el preentrenamiento general haya dejado de importar ni que cualquier archivo corporativo pueda transformarse en un modelo excelente. Sí ofrece una receta y una contabilidad suficientemente concretas para cambiar una decisión de construcción: editores, gobiernos, empresas científicas o redes sanitarias con un corpus singular ya no tienen que elegir sólo entre enviar sus datos a una API externa o gastar miles de millones desde cero.
El próximo dato decisivo no será otra media de benchmarks. Será si el modelo grande mejora de forma medible la revisión de 10.000 documentos en CoCounsel, a qué coste, con cuántas correcciones humanas y bajo qué auditoría. Thomson Reuters ha mostrado que puede poseer el motor. Falta demostrar que esa propiedad produce trabajo más fiable —y que la ruta puede repetirse fuera de la institución excepcional que ya posee Westlaw, Reuters y décadas de criterio editorial.
Fuentes
- Thomson Reuters, anuncio de Thomson y página del modelo, 24 de agosto de 2026.
- Chen et al., Thomson: Continual Learning of Frontier Models for SovereignAI, informe técnico de Thomson Reuters, agosto de 2026.
- Thomson Reuters, pesos, ficha y licencia de Thomson-1.0-Small, consultados el 25 de agosto de 2026.
- Qwen, pesos y ficha de Qwen3.5-397B-A17B, consultados el 25 de agosto de 2026.
- Akyürek et al., PRBench: Large-Scale Expert Rubrics for Evaluating High-Stakes Professional Reasoning, 2025.