JOURNAL / 2026.08.27
Qwen3.8-Flash-Next anticipa Qwen4 con tres formas de memoria
Qwen publica los pesos de un modelo multimodal que busca conservar capacidad usando mucha menos computación de entrenamiento; la arquitectura es inspeccionable, pero sus cifras aún son internas y la nueva licencia limita dos usos comerciales importantes.
Hay lanzamientos que importan por subir una puntuación y otros porque proponen otra manera de gastar la computación. Qwen3.8-Flash-Next, publicado el 26 de agosto, pertenece sobre todo al segundo grupo. Es un modelo multimodal con pesos abiertos y, a la vez, una vista previa experimental de la arquitectura sobre la que Qwen dice estar construyendo Qwen4.
Su red principal tiene 125.000 millones de parámetros, aunque sólo activa 6.000 millones por token. A ella se añade una tabla de embeddings de n-gramas de 51.000 millones de parámetros y un módulo para predecir varios tokens. El repositorio de Hugging Face ya contiene 131 fragmentos BF16 y ocupa unos 360 GB: no es una promesa de publicación futura. El contexto nativo es de 262.144 tokens y puede extenderse a un millón mediante YaRN.
La afirmación central es ambiciosa. En el informe técnico de 28 páginas, el modelo base queda por encima de Qwen3.7-Plus-Base en ocho de catorce pruebas de preentrenamiento y, en las otras seis, no se aleja más de 2,6 puntos. Qwen dice haberlo logrado con un tercio de parámetros activos, un tercio de tokens de entrenamiento y aproximadamente una novena parte de los FLOP de preentrenamiento. No es nueve veces más pequeño ni demuestra todavía que cada tarea cueste nueve veces menos. La diferencia está en cómo combina varias formas de memoria y en qué parte del sistema paga por ellas.
Recordar no exige mirar todo a la vez
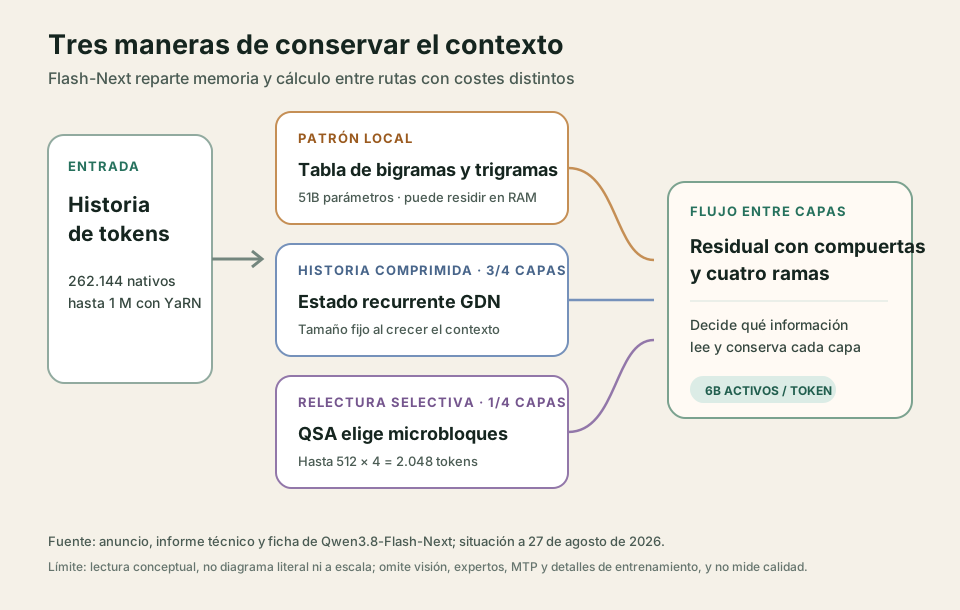
Una forma útil de leer la arquitectura es como tres rutas complementarias. Tres de cada cuatro capas usan Gated DeltaNet: comprimen lo ocurrido antes en un estado recurrente de tamaño fijo. Es barato al alargar el contexto, pero ninguna memoria finita conserva cada token con acceso directo.
La cuarta capa compensa esa pérdida con Qwen Sparse Attention, o QSA. Un indexador agrupa la historia en bloques de cuatro tokens, puntúa esos bloques y selecciona hasta 512 —2.048 tokens en total— para aplicarles atención. Así el modelo puede volver a pasajes concretos sin comparar cada token con todo el pasado. Qwen primero entrenó el indexador para imitar la atención densa y después adaptó conjuntamente la red al patrón disperso; aplicar el índice sin esa segunda fase producía una caída clara.
La tercera ruta es local. Una tabla indexada por bigramas y trigramas aporta 51.000 millones de parámetros de asociaciones cortas. Como las direcciones de lectura se conocen de antemano, la tabla puede permanecer en la RAM del host y adelantarse mientras la GPU calcula. Son parámetros de capacidad, pero no 51.000 millones de multiplicaciones nuevas por token. Esta distinción explica por qué contar todos los parámetros del archivo dice poco sobre su coste de inferencia.
Alrededor de esas rutas, Gated Residual ensancha el flujo residual en cuatro ramas y decide dinámicamente cuánto leer y escribir en cada una. En las ablaciones de Qwen, la compuerta reduce valores extremos y permite entrenar de forma estable con lotes y tasas de aprendizaje mayores. El equipo también usa Muon en las matrices apropiadas y elimina el calentamiento gradual del tamaño de lote, que en su ensayo necesitó un 18,8% más de pasos sin mejorar el resultado. No es una sola invención espectacular: es una cooptimización de atención, memoria, flujo entre capas y entrenamiento.
Dónde termina la medición
La evidencia es más rica que una ficha de lanzamiento habitual. El informe incluye ablaciones a escalas intermedias, condiciones de entrenamiento, comparaciones contra atención completa, pruebas de estabilidad y resultados del modelo base. También reconoce decisiones que parecían buenas durante el preentrenamiento y fallaron después, como leer sólo las dos ramas residuales con mayor puntuación.
Pero sigue siendo evidencia producida por Qwen. Las catorce pruebas que sustentan la novena parte de FLOP comparan modelos base bajo su propia batería; no miden el coste de postentrenamiento, visión, herramientas, reintentos de un agente ni servicio continuo. Las pruebas del modelo final usan varios arneses elegidos por el proveedor, incluyen evaluaciones internas y, en algunos casos, datos corregidos o un juez de otro modelo. Sirven para decidir qué merece una reproducción, no para declarar una clasificación neutral.
Lo mismo ocurre con la velocidad. A un millón de tokens, Qwen informa de que el kernel de QSA es 7,6 veces más rápido durante el procesamiento inicial y 4,9 veces durante la generación que su referencia de atención densa. Son mediciones del módulo de atención, con entrada por fragmentos de 16.000 tokens y una configuración concreta de lote y predicción especulativa; no son la latencia completa de una aplicación. La receta de vLLM vuelve tangible el despliegue, pero también muestra el suelo actual: el checkpoint BF16 ronda los 335 GiB, el FP8 unos 173 GiB y las configuraciones validadas de alto rendimiento distribuyen el modelo entre varios aceleradores de centro de datos. Una tabla descargable a RAM no convierte por sí sola el sistema en un modelo pequeño.
Pesos abiertos con una puerta comercial
La publicación sí permite algo que una API cerrada no: inspeccionar parámetros y configuración, cuantizar, ajustar, ejecutar evaluaciones propias y comprobar si QSA conserva información relevante fuera de las pruebas elegidas por Qwen. Hay soporte inicial en vLLM y SGLang, aunque parte de ese soporte todavía depende de imágenes o ramas específicas del día de lanzamiento. La versión de producción qwen3.8-flash, con herramientas incorporadas y un millón de tokens por defecto, es además una superficie distinta del checkpoint y su API figuraba aún como próxima en el anuncio.
“Pesos abiertos” tampoco significa Apache 2.0. A diferencia del Qwen3.8-27B, Flash-Next usa la Qwen Community License 1.0. Permite copiar, modificar, distribuir y afinar, pero exige una licencia separada para ofrecer comercialmente el modelo como servicio o como asistente independiente de programación o trabajo de oficina. Los productos muy grandes también deben mostrar de forma prominente el nombre del modelo. La arquitectura está abierta a examen; dos de sus mercados más obvios no están abiertos a competencia comercial sin permiso adicional.
Faltan además piezas importantes para una auditoría completa: el informe no describe la mezcla del corpus de preentrenamiento, no ofrece el código de entrenamiento integral ni incluye una evaluación de seguridad del modelo postentrenado. Publicar los pesos permite estudiar mucho más que una API, pero no reproduce el proceso que los creó.
Mi lectura es que Flash-Next importa menos como “otro Qwen rápido” que como una apuesta visible sobre el próximo cuello de botella. Si el contexto y los agentes siguen creciendo, hacer atención densa sobre todo y mantener toda la memoria en el acelerador es una ruta cara. Qwen propone repartir el problema: comprimir la historia, releer sólo regiones elegidas, guardar patrones locales fuera de la GPU y usar compuertas para que el entrenamiento soporte esa heterogeneidad.
La propuesta ya puede ser interrogada porque los pesos existen. Aún no ha sido confirmada porque la comparación de coste, calidad y seguridad procede del mismo equipo que eligió la arquitectura. Las siguientes pruebas valiosas son claras: reproducciones con el mismo presupuesto, latencia y coste de extremo a extremo en contextos realmente largos, pérdida de información en tareas no seleccionadas por Qwen y, finalmente, si Qwen4 adopta estas piezas sin devolver la computación ahorrada en otra capa del sistema. La novena parte es una buena razón para mirar. Todavía no es una razón para multiplicar todas las conclusiones por nueve.
Fuentes
- Qwen Team, Qwen3.8-Flash-Next: A New Architecture, Towards Ultimate Cost-Efficiency, 26 de agosto de 2026.
- Qwen Team, On the Design of Qwen3.8-Next Architecture: Evaluation, Efficiency, and Training Stability, informe técnico, 26 de agosto de 2026.
- Qwen, pesos, configuración, ficha y archivos de Qwen3.8-Flash-Next y Qwen Community License 1.0, consultados el 27 de agosto de 2026.
- vLLM, receta de despliegue de Qwen3.8-Flash-Next, actualizada el 26 de agosto de 2026.
- Qwen, ficha de Qwen3.8-27B, consultada el 27 de agosto de 2026.