JOURNAL / 2026.08.30
Google automatiza la predicción geoespacial con Planetary Prediction Engine
Un agente de Earth AI busca datos, construye conjuntos y entrena modelos en minutos; sus pruebas en salud, alimentos y riesgo son sustantivas, pero el sistema no está abierto y validar una predicción sigue siendo el trabajo decisivo.
Durante el brote de enfermedad por virus de Bundibugyo declarado en mayo en la República Democrática del Congo, un sistema de Google Research recibió una pregunta, reunió señales epidemiológicas y geográficas, construyó variables, probó modelos y produjo un mapa de riesgo. No se limitó a resumir informes. Ejecutó el trabajo que convierte fuentes dispersas en una predicción.
Ese es el cambio que introduce Planetary Prediction Engine (PPE), presentado en un paper del 26 de agosto y en el blog de Google Research al día siguiente. El sistema cubre tres clases de tarea —regresión espacial, aumento de resolución geográfica y predicción epidemiológica— y combina datos públicos con representaciones ya aprendidas por los modelos geoespaciales de Earth AI. En el ejemplo del ébola ejecutó 793 pasos en tres sesiones que sumaron 55,2 minutos.
La cifra merece atención, pero no significa que una consulta de una hora produzca una política sanitaria lista para usar. Mide el tiempo de ejecución de un flujo ya construido sobre registros, plataformas y modelos previos. No incluye el trabajo de crear los datos, desarrollar el sistema, revisar el resultado ni desplegar una intervención. La aportación material es más precisa: una parte que antes exigía semanas de ingeniería especializada puede convertirse en una búsqueda automatizada y trazable de modelos candidatos.
El agente decide qué merece ser una variable
En 2025, Earth AI ya podía descomponer preguntas complejas y consultar modelos especializados de imágenes, población y entorno. PPE avanza un eslabón: recibe datos etiquetados y una pregunta predictiva, identifica la escala espacial y temporal, busca señales plausibles en literatura y fuentes oficiales, descarga conjuntos y los une. Después combina esas variables con embeddings de Population Dynamics Foundation Models y AlphaEarth, y compara modelos lineales, árboles y redes pequeñas bajo distintas regularizaciones.
El LLM es sobre todo un orquestador de herramientas y decisiones. Los artefactos voluminosos pasan entre etapas mediante identificadores opacos, no dentro del contexto del modelo. Esto evita que el tamaño de un dataframe dependa de la ventana de tokens y separa la búsqueda de datos de la etapa que entrena. También permite prohibir que el agente de predicción vuelva a internet o modifique el conjunto una vez comienza la evaluación.
La selección automática de datos es tanto la capacidad más interesante como el riesgo principal. PPE aplica una puerta de cuatro reglas: excluye variables que formen parte matemática del objetivo, procedan de la misma encuesta, sean una consecuencia posterior o pertenezcan al futuro. Conserva además procedencia y licencia. Pero la regla causal la juzga el propio sistema y el paper reconoce que no está verificada formalmente. Una variable puede pasar el filtro y seguir siendo un atajo local, una señal de desigualdad histórica o una correlación que desaparece al cambiar de región.
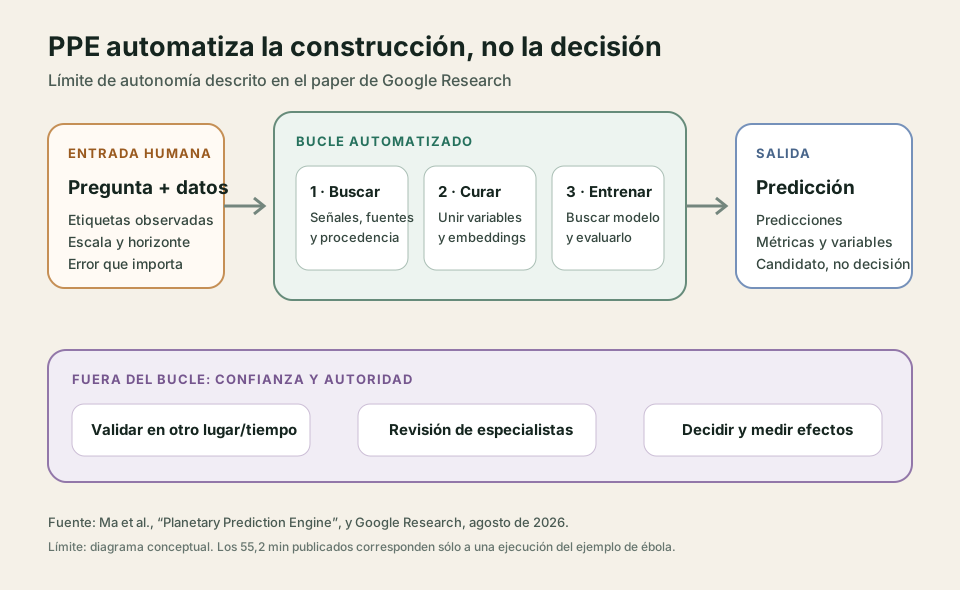
Las pruebas muestran por qué merece estudiarse. En 21 indicadores sanitarios de los CDC, la combinación completa obtuvo un R² medio de 76,8% frente al 60% del flujo experto usado como referencia. En el brote congoleño, las diez zonas que el sistema priorizaba cada semana incluyeron 15 de las 18 zonas invadidas durante cinco pronósticos consecutivos: un Recall@10 de 83,3%, frente a cerca del 73% de la referencia publicada.
Ese resultado del brote es el más convincente porque respeta el orden temporal y se desarrolló con investigadores del Institut National de Recherche Biomédicale. También es estrecho. Son cinco semanas, un patógeno y un brote; el intervalo de confianza publicado para el 83,3% va de 60,8% a 94,2%. Recall@10 mide si una nueva zona apareció entre las diez prioridades, no cuántos casos habrá, si los recursos llegaron a tiempo o si se evitó una infección. El paper no afirma que PPE decidiera la respuesta sanitaria.
Otras cifras necesitan límites distintos. En Nigeria, el 66,1% de R² que «duplica» el 31,5% compara el sistema completo con una referencia basada sólo en estacionalidad y tendencia; añadir vegetación sin todo el agente ya alcanzaba 60,1%. Además, la verdad de terreno local usada para validar la desagregación se estimó mediante otro modelo estadístico a partir de encuestas representativas a una escala más gruesa. Es evidencia útil de resolución espacial, no observación directa de cada localidad.
En las pruebas estadounidenses, la partición aleatoria 80/20 de secciones censales permite que lugares cercanos caigan a ambos lados del corte. El protocolo coincide con la referencia anterior y PPE admite particiones por grupos geográficos, pero esos resultados dicen menos sobre trasladar un modelo a una región verdaderamente nueva. Que un sistema pueda escoger el método de validación correcto no demuestra que cada experimento publicado haya usado el más exigente.
Minutos para proponer; más tiempo para confiar
PPE sigue siendo un proyecto de investigación temprana, no una API ni un paquete descargable. Google publicó el paper, pero no el código, las trayectorias, los modelos orquestadores concretos, el coste de las ejecuciones o un acceso al sistema. Fijar la temperatura de los LLM en cero ayuda poco si otra persona no puede reconstruir el entorno. Algunas piezas sí son accesibles: los embeddings anuales de AlphaEarth están en Earth Engine y Cloud Storage bajo CC BY 4.0, aunque la descarga en la nube repercute el coste al usuario. El ensamblaje autónomo que los convierte en un modelo sigue siendo cerrado.
Tampoco conviene borrar el trabajo humano que hay debajo. Para el brote, algunos partes en PDF fueron transcritos manualmente y tres zonas ausentes del registro se añadieron a partir de informes de situación. Los datos alimentarios procedían de encuestas del Programa Mundial de Alimentos, y la pregunta y las etiquetas siempre las proporciona una persona o una institución. La OMS describe además un contexto de vigilancia incompleta, movilidad e inseguridad: circunstancias en las que el dato observado no es un espejo limpio de la transmisión.
Mi lectura es que PPE no democratiza todavía la predicción planetaria, pero sí demuestra una compresión importante del ciclo entre «tenemos una pregunta» y «tenemos un modelo que merece ser criticado». Eso cambia el cuello de botella. Cuando producir otro modelo cuesta menos de una hora, el recurso escaso deja de ser la primera implementación y pasa a ser la autoridad para decidir qué objetivo importa, qué datos representan a quién, qué división prueba una generalización real y qué error es tolerable.
En tareas de bajo riesgo, esa abundancia permite comparar más hipótesis. En salud pública o ayuda humanitaria también puede fabricar con rapidez mapas convincentes basados en atajos. La respuesta no es exigir que cada paso vuelva a ser manual, sino conservar procedencia, bloquear el conjunto de prueba, evaluar fuera de la geografía conocida, comparar con especialistas y registrar qué decisión cambió realmente gracias al modelo. Un pronóstico debe llegar con su linaje y su dominio de validez, no sólo con un color sobre el mapa.
Google ha automatizado una parte sustantiva de la construcción de modelos geoespaciales. La prueba que falta no cabe en 55 minutos: que equipos ajenos puedan repetirla, descubrir cuándo falla y usarla mejor que el proceso que pretende reemplazar.
Fuentes
- Ma et al., Planetary Prediction Engine: Autonomous Geospatial Prediction via Intelligent Data Selection and Foundation Model Embeddings, preprint, 26 de agosto de 2026.
- Google Research, Planetary prediction engine: Automating global models via Earth AI, 27 de agosto de 2026.
- Google Research, Google Earth AI: Unlocking geospatial insights with foundation models and cross-modal reasoning, 23 de octubre de 2025.
- Google for Developers, catálogo y condiciones de acceso de AlphaEarth Satellite Embedding V1, consultado el 30 de agosto de 2026.
- Organización Mundial de la Salud, Ebola disease caused by Bundibugyo virus — Democratic Republic of the Congo, 21 de mayo de 2026.