JOURNAL / 2026.09.03
Google lanza Gemini 3.8 Flash: un agente más capaz que también trabaja más
El nuevo modelo mejora con claridad en programación de largo recorrido al mismo precio por token que su predecesor; sus propias trazas muestran por qué eso no equivale al mismo coste por tarea.
Google ha lanzado Gemini 3.8 Flash sólo tres semanas después de 3.7 y seis después de 3.6. No es una vista previa: el identificador estable ya está disponible en la API, AI Studio, Antigravity, Gemini Enterprise, la aplicación de Gemini y AI Mode. El modelo conserva un millón de tokens de contexto, 64.000 de salida y tres niveles de razonamiento, pero está afinado para programación de largo recorrido y agentes que usan herramientas durante muchos pasos.
La sucesión rápida puede parecer una actualización más. No lo es del todo. En tareas largas de ingeniería, 3.8 cierra casi toda la distancia entre la familia Flash y modelos mucho más caros. A la vez, la explicación técnica de Google contiene la cautela que mejor define el lanzamiento: el modelo obtiene parte de la mejora porque hace más trabajo. Da más pasos, llama más veces a las herramientas y consume más tokens cuando el esfuerzo está en nivel alto.
El precio del token no es el precio de terminar
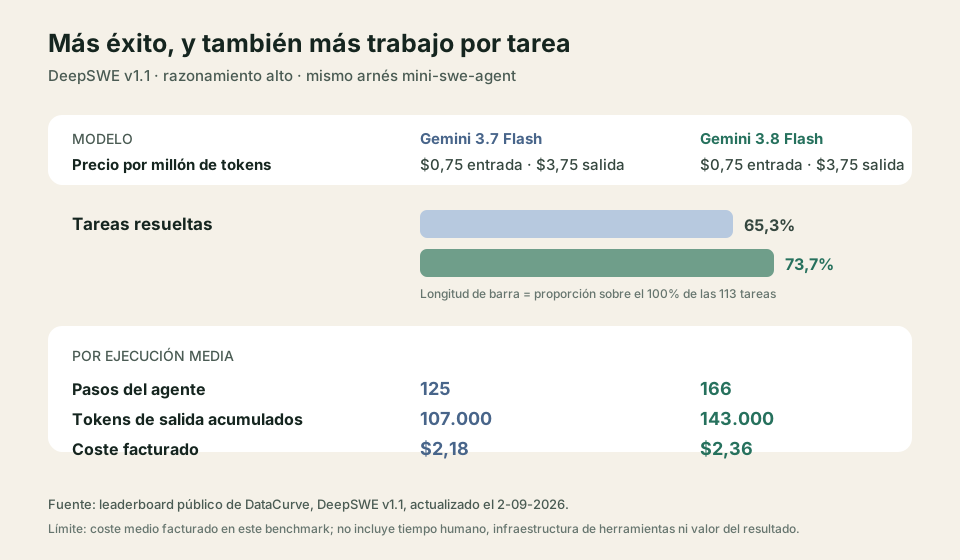
La comparación más limpia está en DeepSWE v1.1, un conjunto de 113 tareas originales sobre 91 repositorios. Los problemas piden cambios de software largos, tienen verificadores escritos a mano y se ejecutan con el mismo arnés mini-swe-agent. En su configuración de razonamiento alto, Gemini 3.8 Flash resuelve el 73,7% de las tareas, frente al 65,3% de 3.7. El intervalo publicado sitúa a 3.8 junto a Claude Opus 5 y GPT-5.6 Sol, no claramente por encima de ellos.
La traza cuenta la otra mitad. Una ejecución media de 3.8 produce 143.000 tokens de salida repartidos entre llamadas y da 166 pasos; 3.7 usa 107.000 y 125. El coste facturado por tarea pasa de 2,18 a 2,36 dólares. Es una subida modesta para ocho puntos de éxito, pero demuestra que «el mismo precio» sólo describe la tarifa unitaria. No describe latencia total, ocupación de herramientas ni gasto de reintentos. Tampoco esos porcentajes son una tasa universal de proyectos terminados: el benchmark entrega una petición ya definida, un repositorio preparado y pruebas que saben qué significa acertar.
La metodología de evaluación de Google ayuda a no convertir una tabla en una clasificación absoluta. El resultado de DeepSWE para 3.8 fue calculado por Google con razonamiento alto, aunque coincide con el que muestra el leaderboard público. En Terminal-Bench 4.0, una prueba más general de agentes, 3.8 sube de 11,2% a 19,1% respecto a 3.7, pero queda lejos del 51,8% de Opus 5. En HLE-Verified, de razonamiento experto multidisciplinar, la diferencia es sólo de 53,6% a 54,9%. El avance es grande donde el entrenamiento y el arnés encajan bien; no convierte a Flash en el mejor modelo para cualquier trabajo.
Esto cambia cómo conviene evaluar una migración. Google mantiene hasta el 31 de diciembre la tarifa introductoria de 0,75 dólares por millón de tokens de entrada y 3,75 por el de salida; el 1 de enero ambas cifras se duplicarán. La guía para desarrolladores recomienda bajar el esfuerzo para tareas ordinarias o conservar 3.7 cuando prima la eficiencia. Para decidir entre ambos no basta repetir un prompt corto: hace falta medir la proporción de tareas completas, el coste de todas las llamadas, el tiempo hasta una salida verificable y el daño posible de una acción errónea. Un agente que cuesta un 8% más y termina bastante más puede ser barato; uno que alarga cada recorrido sin mejorar la prueba local no lo es.
La variante Cyber abre otra frontera
El lanzamiento incluye Gemini 3.8 Flash Cyber, que comparte la inteligencia de base pero aplica mitigaciones más permisivas para investigación defensiva. No está en la API general. Google lo ofrece, solo o dentro del agente CodeMender, a más de 650 organizaciones del programa Fairwind: autoridades públicas, operadores de infraestructura crítica, plataformas de software y equipos de seguridad aprobados. Los participantes deben limitarlo a personal de ciberseguridad, usar autenticación individual y multifactor resistente al phishing, registrar el acceso y no redistribuirlo.
Aquí también conviene mirar la tarea completa. CWE-bench oculta 100 auditorías de repositorios y sólo da por buena una solución si bloquea el exploit sin romper las pruebas existentes. Flash Cyber resuelve el 47,2% a 3,64 dólares por intento; Fable 5 llega al 47,8% por 10,27 dólares y el Gemini 3.7 general al 44,0% por 1,43. Es evidencia independiente y útil de una nueva combinación de capacidad y coste. También dice que más de la mitad de los intentos falla. Las afirmaciones más espectaculares —más del 70% en un conjunto interno de veinte lenguajes o un hallazgo crítico en menos de dos horas— proceden de Google y no traen los artefactos necesarios para reproducirlas.
La documentación pública es desigual. La tarjeta de Gemini 3.8 Flash cubre el modelo general y dice que no añade aumentos materiales en los dominios del Frontier Safety Framework respecto a 3.7, cuya evaluación no alcanzó sus umbrales de capacidad. También registra un empeoramiento de 5,4 puntos porcentuales en una evaluación automatizada de seguridad multilingüe, sin publicar las tasas absolutas; Google afirma que la revisión manual de las pérdidas encontró sobre todo falsos positivos o casos no graves. El material de Fairwind describe controles de acceso y resultados de Cyber, pero no ofrece una tarjeta separada con el mismo nivel de detalle. Una política de admisión ayuda a gobernar quién usa el modelo; no sustituye la evidencia sobre qué puede hacer tras conseguir acceso.
Mi lectura es que 3.8 vuelve menos útil hablar de modelos «rápidos» y «caros» como categorías fijas. El sistema puede intercambiar razonamiento por tiempo y dinero dentro del mismo identificador, y su coste real nace de la combinación entre modelo, nivel de esfuerzo, arnés, herramientas y criterio de parada. Para construir con él, el objeto que merece versión y evaluación ya no es sólo el prompt: es el recorrido completo.
Gemini 3.8 Flash sí ofrece un avance material en agentes de programación a una tarifa accesible y con disponibilidad inmediata. Pero su mejor lección no cabe en el 73,7%. Está en las 166 decisiones que lo producen. Cuanto más capaz sea un agente de seguir trabajando, más importante será fijar de antemano qué prueba demuestra que ya ha terminado.
Fuentes
- Google, Introducing Gemini 3.8 Flash and 3.8 Flash Cyber, 2 de septiembre de 2026.
- Google DeepMind, tarjeta de Gemini 3.8 Flash, 2 de septiembre de 2026.
- Google AI for Developers, guía y migración de Gemini 3.8 Flash, actualizada el 2 de septiembre de 2026.
- DataCurve, DeepSWE v1.1, leaderboard actualizado el 2 de septiembre de 2026.
- Collinear, CWE-bench, versión 0, 1 de septiembre de 2026.
- Google DeepMind, Fairwind Program, consultado el 3 de septiembre de 2026.