JOURNAL / 2026.09.07
OpenAI declara un becario de investigación automatizado: qué miden sus datos
OpenAI afirma que sus agentes ya completan tareas de investigación de varios días, pero su propia telemetría distingue con claridad entre tiempo de máquina, trabajo validado y aceleración científica.
OpenAI dice haber alcanzado un hito que hasta ahora era sobre todo una fecha en su hoja de ruta: un «becario de investigación automatizado». La expresión no designa un producto nuevo ni un sistema que elija y ejecute por sí solo un programa científico. En la definición publicada el 6 de septiembre, es un agente capaz de realizar bajo dirección humana tareas bien delimitadas que ocuparían varios días a un investigador cualificado.
La noticia merece atención porque viene acompañada de algo poco habitual: datos sobre el uso real de agentes dentro de un laboratorio de frontera. También exige leer tres escalas que el titular tiende a mezclar. OpenAI muestra cuánto cómputo consumen los agentes, algunos indicios de que terminan trabajo útil y una correlación con más código y experimentos. No publica una medida causal de cuánto más rápido mejora sus modelos, ni una evaluación externa del supuesto becario.
Tres jornadas de ejecución no son tres investigadores
A mediados de agosto, el investigador mediano de OpenAI utilizaba más de 600 dólares diarios de inferencia valorada a precios de API; el percentil 90 superaba los 7.000. Son equivalentes de precio, no necesariamente el coste marginal que paga la empresa. Antes de junio, el tiempo agregado de ejecución de agentes aún estaba por debajo del tiempo laboral humano; a mediados de agosto había llegado a 3,1 jornadas de agente por cada jornada humana, convirtiendo ocho horas de ejecución en una unidad común.
Esa relación mide ocupación de máquinas. Un investigador puede lanzar varias sesiones a la vez; éstas pueden crear subagentes, esperar una prueba, recorrer un callejón sin salida o repetir trabajo. Nada en la unidad garantiza que una hora de agente produzca lo mismo que una hora humana. El dato importante es operativo: la investigación ya absorbe más tiempo paralelo de agentes que tiempo de personas. Traducirlo como «tres veces más producción» añadiría una equivalencia que OpenAI no ha medido.
La capa siguiente se acerca más al resultado. Durante 2026 aumentaron los experimentos por experimentador activo y agosto marcó el máximo desde que comenzó el registro en enero de 2025. Los investigadores también aportan código con mayor rapidez. Pero la propia empresa señala que el cómputo disponible creció mucho durante el mismo periodo. No hay un grupo comparable sin Codex, ni una estimación que separe mejores modelos, más hardware, cambios de plantilla o proyectos distintos. Más experimentos pueden acelerar el descubrimiento; también pueden ser intentos más baratos que nunca llegan a un entrenamiento principal.
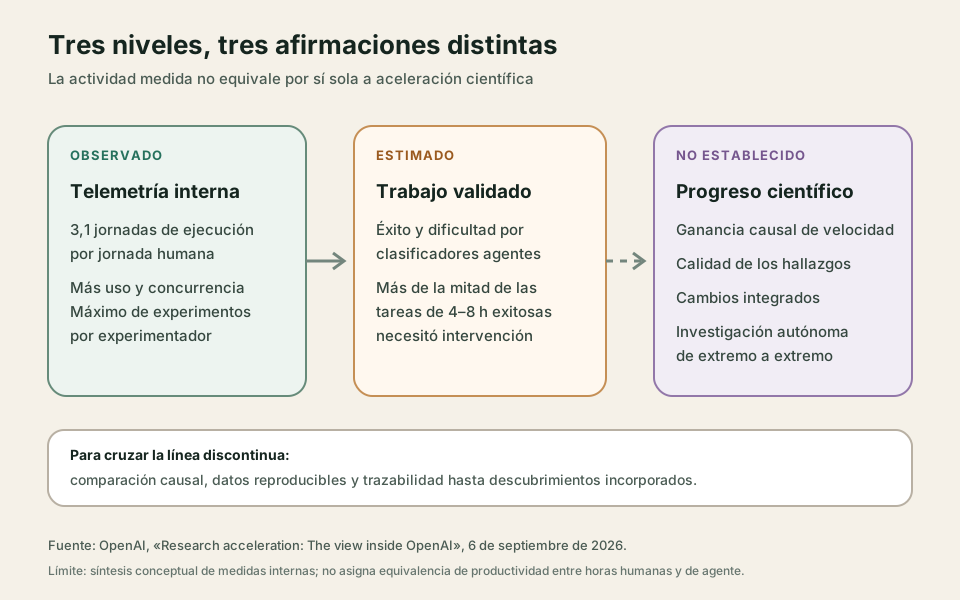
Para estimar si una tarea tuvo éxito, OpenAI usó un clasificador agente sólo donde encontró un resultado comprobable. Otro cálculo aproxima la dificultad mediante las horas que tardaría una persona. La gráfica excluye los resultados inciertos y los grupos con menos de cincuenta sesiones o cincuenta usuarios, pero la página no ofrece la serie de datos ni detalle suficiente para reproducir externamente el análisis. Entre las tareas exitosas estimadas en cuatro a ocho horas humanas, más de la mitad necesitó al menos una intervención en los últimos seis meses. El hito describe trabajo de varios días que puede completarse con dirección; no demuestra varios días sin supervisión.
El reparto de tareas refuerza esa lectura. OpenAI clasificó los tokens de los agentes con una taxonomía de Epoch AI que divide la I+D en decidir, diseñar, construir, ejecutar, analizar y comunicar. Crecieron todas las categorías entre enero y agosto, sobre todo el soporte técnico y la vigilancia de ejecuciones, mientras la planificación de alto nivel siguió siendo una fracción mínima. Epoch había creado precisamente la taxonomía para evitar confundir tareas fáciles de contar con la automatización de un oficio completo; advierte que ajustar un modelo pequeño no equivale a coordinar proyectos ambiguos sobre millones de líneas de código.
El cuello de botella se desplaza, no desaparece
El uso interno ya cambia lo que se puede hacer. Varias sesiones pueden preparar datos, arreglar infraestructura, lanzar pruebas y analizar resultados mientras una persona conserva el contexto entre ellas. OpenAI cuenta que disminuyeron las consultas a uno de sus principales canales humanos de soporte y que un equipo dejó sus horas de oficina; es una observación organizativa coherente con sustitución local, aunque no una auditoría general de productividad. Para otros laboratorios, la lección práctica es que el recurso escaso se mueve desde escribir cada línea hacia formular tareas, proporcionar entornos fiables, decidir qué resultados merecen continuar e integrar el cambio correcto.
Esa multiplicación también amplifica los errores y el área expuesta. Tras el incidente de Hugging Face, OpenAI cerró temporalmente el 20 de julio el servicio de contenedores empleado en entrenamiento y lo restauró con restricciones. La pausa de aprendizaje por refuerzo que analizamos en agosto redujo bruscamente esas ejecuciones. Cuando la evidencia preliminar sobre la capacidad cibernética de Astra impuso controles adicionales el 7 de agosto, su asignación de GPU cayó otro 59,2% durante la semana siguiente. Sin embargo, la asignación a otras clases de modelos subió un 17,2% y compensó aproximadamente el 85% de esa caída.
Es uno de los resultados más útiles del nuevo informe. Restringir un modelo concreto puede ralentizar ese carril sin reducir en la misma medida el ritmo total de una organización: el cómputo y la atención encuentran otro trabajo. Un control de seguridad sigue siendo valioso —Astra se lanzó finalmente con acceso y ejecución limitados—, pero no debe confundirse con una política de velocidad agregada. Si el objetivo es regular el ritmo, la unidad relevante incluye las alternativas a las que se desplazan personas y aceleradores.
La publicación llega junto a An Alien Mind, un ensayo del científico jefe Jakub Pachocki. Allí sostiene, a partir de resultados internos no detallados, que el progreso podría sostenerse hasta la mejora recursiva, y dice que ningún laboratorio ha resuelto alineamiento y monitorización lo suficiente para seguir escalando a máxima velocidad durante mucho más tiempo. Pide que las ralentizaciones voluntarias se vuelvan habituales hasta establecer umbrales compartidos. Son una previsión y una posición del autor, no conclusiones demostradas por la telemetría. La meta de OpenAI de un investigador automatizado para marzo de 2028 es igualmente un objetivo declarado, no una extrapolación validada por los datos del informe.
Mi lectura es que el hito nominal importa menos que la aparición de una capa industrial de trabajo agente dentro del proceso que crea los modelos siguientes. Ya hay evidencia interna de ejecución paralela masiva, tareas más largas, más experimentos y sustitución de soporte técnico. Falta la cadena que enlazaría todo eso con descubrimientos aceptados, mejoras incorporadas, tiempo y cómputo ahorrados, fallos introducidos y resultados que no habrían ocurrido sin los agentes.
Publicar esa cadena de forma agregada y auditable sería más valioso que discutir si «becario» es la palabra exacta. Un estándar común debería distinguir horas ejecutadas, tareas validadas, intervenciones humanas, cambios integrados y progreso científico, además de registrar incidentes y trabajo de seguridad. OpenAI ha abierto una ventana importante, pero conserva los datos, los clasificadores y la definición del éxito. El siguiente paso verificable no es otro nombre para el sistema: es permitir comparar cuánto trabajo adicional se convierte realmente en conocimiento y bajo qué controles.
Fuentes
- OpenAI, Research acceleration: The view inside OpenAI, 6 de septiembre de 2026.
- Jakub Pachocki, OpenAI, An Alien Mind, 6 de septiembre de 2026.
- Denain, Kwon y Ho, Epoch AI, Toward an O*NET for AI R&D, 17 de junio de 2026.
- OpenAI, Pacing model development in an era of cyber-critical capabilities, 18 de agosto de 2026.