JOURNAL / 2026.09.12
Fugu Max y Ultra v2 convierten varios modelos en una sola API
Sakana AI vende selección, delegación y síntesis de varios modelos como si fueran un único endpoint; la idea cambia qué significa comparar capacidad y coste, pero el nuevo sistema aún carece de una evaluación reproducible.
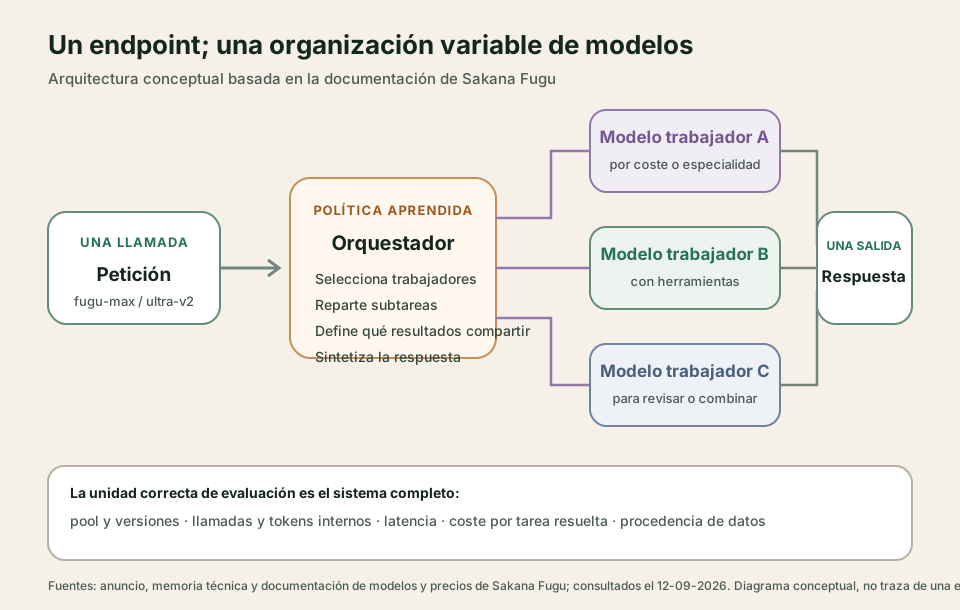
Cuando una aplicación llama a fugu-max, no está eligiendo un único modelo que responderá de principio a fin. Está entregando esa elección a otro modelo. Éste puede decidir qué trabajadores usar, repartirles subtareas, compartir ciertos resultados entre ellos y sintetizar una respuesta. La interfaz conserva la forma familiar de una llamada a un modelo; la unidad real de cómputo se ha convertido en un equipo.
Sakana AI lanzó Fugu Max y Fugu Ultra v2 el 11 de septiembre. Max busca la mejor relación entre rendimiento y precio usando el pool más amplio de la empresa, que incluye modelos Nemotron de pesos abiertos. Ultra v2 dedica más trabajo a problemas complejos y persigue la máxima calidad. Ambos están disponibles mediante una API compatible con OpenAI y sustituyen una integración con sólo cambiar el identificador del modelo.
Ésa es una novedad práctica, no sólo una manera distinta de nombrar un router. El desarrollador puede pedir una tarea sin prescribir si hace falta un modelo barato, un especialista visual, varios agentes de código o una ronda de verificación. Sakana entrena un coordinador para tomar esas decisiones a partir de la petición y del estado de la tarea. El producto desplaza una parte del diseño del sistema —qué modelo llama a cuál y cuándo— desde el código de la aplicación hacia una política aprendida.
El modelo es también la organización del trabajo
La memoria técnica de Fugu, publicada para la primera versión en junio, describe dos mecanismos. La variante rápida usa los estados internos de un modelo coordinador y una pequeña cabeza de selección para escoger un trabajador en cada paso. Fue entrenada primero con tareas verificables: se ejecutaban todos los modelos candidatos y el coordinador aprendía cuál tendía a funcionar mejor. Después se optimizó sobre trayectorias reales de agentes de código, donde la recompensa dependía de terminar la tarea y no sólo de contestar bien una pregunta aislada.
Ultra sigue la línea del Conductor, un modelo entrenado por refuerzo para escribir flujos de trabajo en lenguaje natural. Puede dividir una petición, asignar cada parte a un trabajador y decidir qué salidas anteriores verá el siguiente. Esos flujos no están limitados al sencillo patrón de «uno propone y otro revisa»: pueden formar cadenas, ramas paralelas, votaciones o llamadas recursivas al propio coordinador. El trabajo previo TRINITY aporta la versión ligera de selección iterativa de modelos y roles.
Esto aclara por qué llamar «modelo» a Fugu no es del todo falso, aunque resulte incompleto. Hay pesos entrenados que toman decisiones; sencillamente, buena parte de la capacidad que recibe el usuario procede de los modelos trabajadores y del cómputo añadido durante la inferencia. Es parecido a evaluar un equipo por su resultado final, salvo que aquí el organigrama se genera de nuevo para cada problema.
También aclara lo que este lanzamiento no abre. Fugu Max incorpora modelos de pesos abiertos, pero ni Max ni Ultra v2 son un checkpoint descargable. Son servicios alojados. La documentación de modelos dice que los pools de Max y Ultra son fijos; sólo el Fugu normal permite excluir proveedores desde la consola. La página no enumera el pool completo actualizado. Ultra v2 excluye expresamente Claude Fable 5, Fable 5.1 y GPT‑6 Astra, lo que demuestra que sus resultados no son una simple llamada encubierta a esos tres sistemas, pero no demuestra que todos sus trabajadores sean abiertos ni que la dependencia de proveedores haya desaparecido.
La propia disponibilidad dibuja otro límite: el servicio no se ofrece aún en la Unión Europea ni en el Espacio Económico Europeo mientras Sakana trabaja en el cumplimiento del RGPD. Una API compatible reduce el coste de migrar código; no resuelve por sí sola residencia de datos, contratos, auditoría o continuidad de cada modelo situado detrás.
El precio de un token no es el precio de resolver una tarea
Sakana afirma que Max obtiene el mejor resultado agregado en seis benchmarks y amplía la frontera entre coste y rendimiento en siete de diez. Para Ultra v2 atribuye el mejor resultado, en solitario o empatado, en cinco de ocho pruebas de código, herramientas, documentos y razonamiento visual. La afirmación interesante no es que todos esos tests representen la inteligencia general. Es que una política que selecciona y coordina trabajadores puede superar a cualquiera de ellos en tareas que se benefician de planificación, ejecución y revisión.
Pero la evidencia pública del 11 de septiembre es todavía una evaluación del proveedor. El informe enlazado en el anuncio sigue siendo la versión de junio y documenta el pool, las configuraciones y los resultados de Fugu Ultra v1, no los experimentos nuevos de Max y Ultra v2. El anuncio ofrece gráficos y resultados agregados, pero no publica las ejecuciones, las respuestas, el número de llamadas internas por tarea ni una receta con la que otra parte pueda reconstruir la comparación. Una de las pruebas citadas, SWEFish, es además un conjunto interno basado en los propios retos y casos de uso de Sakana.
Hay una segunda dificultad en el eje del coste. Max cuesta, según la tarifa pública, 2 dólares por millón de tokens de entrada y 6 por millón de salida. Ultra v2 cuesta 5 y 30 dólares respectivamente en contextos normales. Son precios unitarios atractivos, pero no dicen cuánto cuesta terminar una tarea. Para Ultra, la misma documentación separa los tokens visibles de los tokens usados internamente por la orquestación y explica que estos últimos cuentan en el precio. Si varios trabajadores leen contextos largos, producen propuestas y se verifican entre sí, una respuesta final corta puede apoyarse en muchas más unidades facturadas.
Por eso comparar sólo dólares por millón de tokens de salida enfrenta magnitudes distintas: el token de un modelo directo y el token final de un sistema que quizá ejecutó varios modelos antes. La comparación útil para construir es coste por tarea resuelta con una latencia y una tasa de error definidas. También debería incluir la dispersión entre ejecuciones, porque un orquestador puede elegir equipos diferentes ante peticiones parecidas.
Esto no invalida el ahorro. Una política capaz de enviar muchas peticiones a modelos pequeños y reservar equipos caros para los casos difíciles puede reducir el gasto total. Incluso puede mejorar la disponibilidad si sustituye un trabajador que desaparece. Pero esas ventajas tienen que observarse sobre una distribución real de trabajo, incluyendo intentos fallidos y cómputo interno; no se deducen de una tarifa nominal ni de escoger el mejor punto de cada gráfica.
Mi lectura es que Fugu Max señala un cambio importante en el mercado de modelos. El endpoint deja de prometer una identidad técnica estable y empieza a prometer un nivel de servicio: «dame el mejor resultado que este presupuesto permita». Eso puede ser exactamente lo que necesita una aplicación. También concentra poder en una capa nueva, porque el orquestador decide qué proveedores reciben los datos, cuánto cómputo gastar y qué versión de cada trabajador influye en el resultado.
La prueba que falta no requiere otro gran marcador. Sakana podría publicar para Max y Ultra v2 un manifiesto versionado del pool, las configuraciones de evaluación, el gasto total de tokens y tiempo por tarea, los intentos completos de una muestra reproducible y resultados frente a routers sencillos con el mismo presupuesto. Para despliegues sensibles haría falta además una procedencia por respuesta: qué clases de modelos intervinieron y bajo qué reglas de datos, aunque las trazas privadas de razonamiento sigan cerradas.
Fugu vuelve cómoda una idea que hasta ahora exigía construir infraestructura propia: tratar la coordinación como una forma de escalar la inferencia. El salto conceptual es real. La siguiente disciplina editorial y técnica debe ser igual de clara: cuando detrás de «un modelo» trabaja una organización variable de modelos, capacidad, coste, privacidad y dependencia sólo se pueden evaluar en el nivel del sistema completo.
Fuentes
- Sakana AI, Introducing Fugu Max and Fugu Ultra v2: Orchestrating the Pareto Frontier, 11 de septiembre de 2026.
- Sakana AI, Sakana Fugu Technical Report, versión 2, 23 de junio de 2026.
- Sakana AI, documentación de modelos y API y precios y contabilidad de tokens de orquestación, consultados el 12 de septiembre de 2026.
- Sakana AI, Learning to Orchestrate Agents in Natural Language with the Conductor y TRINITY: An Evolved LLM Coordinator, trabajos aceptados en ICLR 2026.