JOURNAL / 2026.09.15
Épi publica 120 resultados récord: qué verifica realmente
El sistema de investigación de Bake AI entrega construcciones, cotas y una prueba con certificados públicos; la evidencia sostiene avances comprobables, pero aún no una medida completa de autonomía científica.
Un agente puede proponer mil soluciones y acertar una. Un sistema de investigación tiene una exigencia más difícil: conservar lo aprendido, distinguir una mejora real de un espejismo numérico y dejar evidencia que otra persona pueda comprobar. Épi, presentado por Bake AI el 12 de septiembre, intenta convertir esa diferencia en arquitectura.
La empresa atribuye a sus agentes 120 resultados que mejoran registros previos en unos días: 20 cotas numéricas repartidas entre doce familias de problemas y 100 construcciones en otras ocho. Aparte cuenta una extensión de un caso de la conjetura de Tuza asistida por ordenador. La mayoría de los resultados, según Bake, se obtuvo con GPT‑5.6 Sol y GPT‑6 Astra. El anuncio describe memoria entre sesiones, estrategias que cambian con la evidencia, experimentos paralelos en sandboxes persistentes y un verificador que permanece fijo dentro de cada investigación.
Lo nuevo no es sólo que un modelo haya encontrado una cifra mejor. Es la pretensión de sostener muchas búsquedas, en dominios distintos, sin perder los intentos anteriores, y de publicar el resultado en una forma que no dependa de creer la respuesta del modelo. El repositorio de Épi Results contiene índices, coordenadas de construcciones, testigos, certificados, fuentes de comparación y sumas de comprobación. Eso coloca a Épi por encima de una colección de vídeos o capturas de pantalla. No lo convierte todavía en un laboratorio autónomo demostrado.
Ciento veinte no significa ciento veinte teoremas
El total mezcla objetos de pesos científicos distintos. Ochenta y dos de las 100 construcciones son instancias de sólo dos familias: empaquetar círculos en un cuadrante y bolas en cuatro dimensiones. Cada valor del número de objetos cuenta como un récord separado. Otras entradas son rutas de vehículos, empaquetados de pentágonos o desigualdades optimizadas. Son mejoras concretas y potencialmente útiles como puntos de partida, pero el recuento no equivale a 120 ideas independientes ni a 120 preguntas elegidas por el sistema.
Las 20 cotas incluyen resultados más cercanos a una contribución matemática tradicional. Épi reduce de 4,5238 a 4,29569 una cota superior para la constante de crecimiento de los poliominós mediante un certificado exacto con 1.186 tipos de vecindarios. Estrecha unas 84 veces el intervalo riguroso publicado para la constante de las n reinas. En dimensiones 10 y 11 obtiene cotas certificadas que, si la comparación es correcta, prueban que el conocido programa lineal de Cohn–Elkies no puede alcanzar la densidad exacta de empaquetamiento de esferas. Son clases distintas de avance: una mejor construcción, un intervalo más estrecho y un límite de un método no dicen lo mismo, aunque quepan en la palabra «récord».
El ejemplo más revelador sobre el proceso quizá sea más modesto. En una sesión de 56 minutos, Épi mejoró 17 veces una disposición publicada de 34 pentágonos dentro de un triángulo. Las dos primeras propuestas aportaron la mayor parte de la ganancia; otras quince extrajeron el resto. Aquí se ve el valor de la continuidad: el agente no sólo genera una respuesta, sino que conserva un mejor resultado y sigue explorando contra la misma regla de aceptación. También se ve el límite: un optimizador persistente dentro de una métrica clara no es lo mismo que formular la pregunta que merece ser investigada.
El comprobador termina donde empieza el juicio matemático
La extensión de Tuza permite mirar más de cerca esa frontera. La conjetura relaciona el menor conjunto de aristas que toca todos los triángulos de un grafo con el mayor conjunto de triángulos que no comparten aristas. El trabajo de Épi amplía un caso previo para grafos divididos cuyo núcleo completo tiene ocho vértices: entre los vértices externos que participan en triángulos admite ahora hasta tres tipos distintos de vecindad, en lugar de dos, con multiplicidad arbitraria.
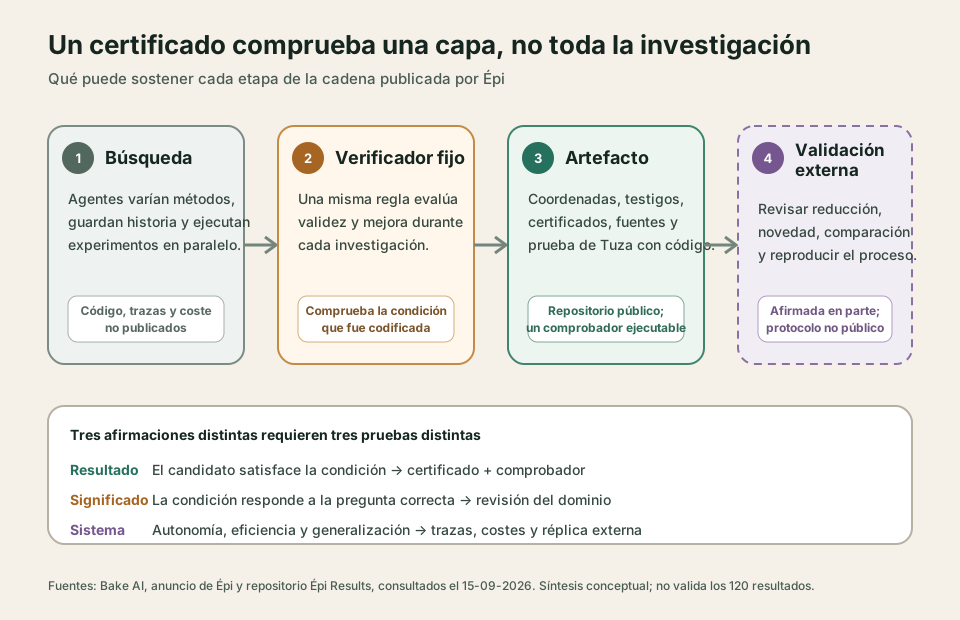
La prueba publicada reduce el problema a 872 clases. Argumentos generales cubren 312 y un certificado enumera las 560 restantes mediante 18.444 cajas de multiplicidades. En nuestra revisión ejecutamos el comprobador independiente incluido: regeneró la clasificación, recorrió el certificado y terminó sin errores con esas mismas cifras.
Eso es evidencia sustantiva, pero conviene nombrar exactamente qué prueba. El programa comprueba que las cubiertas y empaquetamientos codificados satisfacen la desigualdad en la región finita declarada. No certifica por sí solo los argumentos escritos que justifican la reducción, el lema que extiende multiplicidades hasta el infinito, la novedad bibliográfica ni que una ejecución ajena haya reproducido el resultado desde cero. Bake afirma que hubo una revisión independiente, pero la página pública no identifica al revisor ni describe su protocolo. Además, sólo este resultado incluye en el repositorio un comprobador ejecutable; otros certificados se publican como artefactos cuya validación separada se afirma, pero sin el código correspondiente en la misma entrega.
Hay otra ausencia importante. Bake no publica el código de Épi, las trazas completas, el conjunto inicial de problemas, los criterios de selección, el número total de intentos, el cómputo o los tokens consumidos por resultado ni una contabilidad del trabajo humano. Sin esos denominadores no se puede medir la tasa de acierto, comparar eficiencia con una búsqueda especializada o saber cuánto filtrado editorial hubo entre la exploración y los 120 récords finales. El caso fallido que sí muestra —siete horas y 31 enfoques sin mejorar un polinomio plano— es útil precisamente porque recuerda que un registro sólo enseña los éxitos elegidos.
Esta distinción encaja con una evidencia aparentemente contraria. Un estudio de dos evaluaciones sombra dio a agentes de frontera seis días para reconstruir preguntas centrales de papers de NeurIPS aún no publicados. Los agentes hicieron la ingeniería, pero los autores originales rechazaron ambos trabajos por no avanzar sustancialmente en la investigación. Épi no refuta ese resultado. Opera sobre problemas donde una función objetivo, una prueba exhaustiva o aritmética de intervalos puede ofrecer una señal mucho más nítida. Elegir qué pregunta importa, corregir una metodología mal planteada y reconocer una explicación profunda siguen siendo otra clase de trabajo.
Mi lectura es que el avance real está entre dos relatos extremos. Épi no demuestra un científico autónomo general; sí muestra una fábrica de candidatos capaz de mantener contexto, variar métodos y acumular mejoras en entornos verificables, y acompaña algunas de ellas con objetos que resisten una comprobación mecánica. Esa combinación puede cambiar la práctica en matemáticas computacionales, diseño algorítmico y optimización: no porque elimine al especialista, sino porque le entrega un frente más amplio de candidatos concretos para auditar.
La siguiente versión de la evidencia debería hacer auditable también el sistema que produjo los certificados. Publicar el protocolo, un registro íntegro de intentos y costes, la intervención humana y verificadores reproducibles para cada familia permitiría comparar Épi con otros agentes y con métodos especializados. Después hacen falta revisión matemática identificada, reproducción externa y, cuando el dominio salga de lo formal, contraste experimental. Un certificado puede cerrar una desigualdad. No puede, por sí solo, cerrar la pregunta de quién hizo la investigación ni cuánta de ella puede generalizarse.
Fuentes
- Bake AI, Épi: Turning compute into verifiable improvement, 12 de septiembre de 2026.
- BakeLab, repositorio Épi Results, artefactos y comparaciones consultados el 15 de septiembre de 2026.
- BakeLab, prueba y certificado del caso de la conjetura de Tuza, consultados el 15 de septiembre de 2026.
- Zijian Zeng, Tuza’s Conjecture for Split Graphs with an Eight-Vertex Clique Part and Two Neighborhood Types, agosto de 2026.
- Peter Kirgis et al., Can AI agents conduct open-ended AI research? Early evidence from two case studies, 29 de julio de 2026.