JOURNAL / 2026.09.21
Huawei Atlas 960E acerca la óptica a 4.096 aceleradores de IA
Huawei rediseña la interconexión de su próximo superordenador de IA alrededor de óptica cercana al chip; la arquitectura afronta un cuello de botella real, pero los aceleradores llegan en 2027 y sus cifras aún son promesas del proveedor.
Huawei presentó el 17 de septiembre el Atlas 960E SuperPoD, un sistema que conectará hasta 4.096 aceleradores Ascend 960 mediante UnifiedBus y motores ópticos Hi-ONE. La empresa le atribuye un petabyte de memoria HBM y picos de 8 exaflops en FP8 o 16 en FP4. Es una escala suficiente para que el cableado, la energía de mover datos y los fallos de miles de enlaces sean parte del ordenador, no accesorios alrededor de los chips.
Ésa es la novedad material: el Atlas 960E emplea near-packaged optics (NPO), óptica situada junto al silicio que origina el tráfico. Huawei no ha publicado un resultado de entrenamiento ni un modelo obtenido con la máquina. Tampoco puede instalarse hoy: el Ascend 960DT estará disponible en el primer trimestre de 2027 y el 960PR en el tercero, mientras la compañía no fija una fecha de entrega para el sistema completo. La presentación merece atención como arquitectura y calendario industrial, no como rendimiento ya demostrado en producción.
Acortar la parte eléctrica del viaje
Un SuperPoD intenta que muchos nodos físicos se comporten como una sola máquina lógica, con direccionamiento de memoria unificado y una interconexión de alta velocidad. Al crecer, el problema deja de ser únicamente cuántas operaciones hace cada acelerador. Un entrenamiento distribuido se detiene a intercambiar gradientes, activaciones y estados; si la red pierde tiempo, energía o disponibilidad, añadir chips aumenta la cifra de catálogo más deprisa que el trabajo útil.
La definición técnica del Optical Internetworking Forum coloca un motor NPO en la placa principal, adyacente al procesador, para minimizar la longitud de las pistas eléctricas. La señal se convierte antes en luz y recorre en fibra la distancia que el cobre soporta peor a tasas altas. No es lo mismo que integrar óptica y procesador en un único encapsulado; conserva dos componentes cercanos y, con ello, una frontera física que puede facilitar su fabricación o sustitución.
Huawei dice que cada Hi-ONE transmite 7,2 terabits por segundo y lleva incorporada su fuente de luz. En el diseño completo, 5.500 motores Hi-ONE evitarían 48.000 módulos ópticos enchufables de 800G. La empresa calcula que esa sustitución reduce más de 550 kilovatios, duplica el tiempo de funcionamiento sin fallos y permite una disponibilidad del 99,8 %. Las cantidades hacen visible el argumento: a esta escala, cambiar el lugar de la conversión electroóptica puede ahorrar decenas de miles de piezas activas y una carga eléctrica propia de infraestructura industrial.
También marcan el límite de la evidencia. Huawei no publica la configuración de referencia que consume esos 550 kilovatios adicionales, el periodo usado para estimar disponibilidad, una distribución de fallos ni mediciones realizadas por un tercero. Los 8 y 16 exaflops son picos en formatos numéricos de baja precisión, no velocidad sostenida al entrenar un modelo identificado. FP4 duplica aritméticamente a FP8 en la ficha, pero esa relación no dice qué precisión conserva un entrenamiento ni cuánto tiempo pasan ociosos los chips esperando datos.
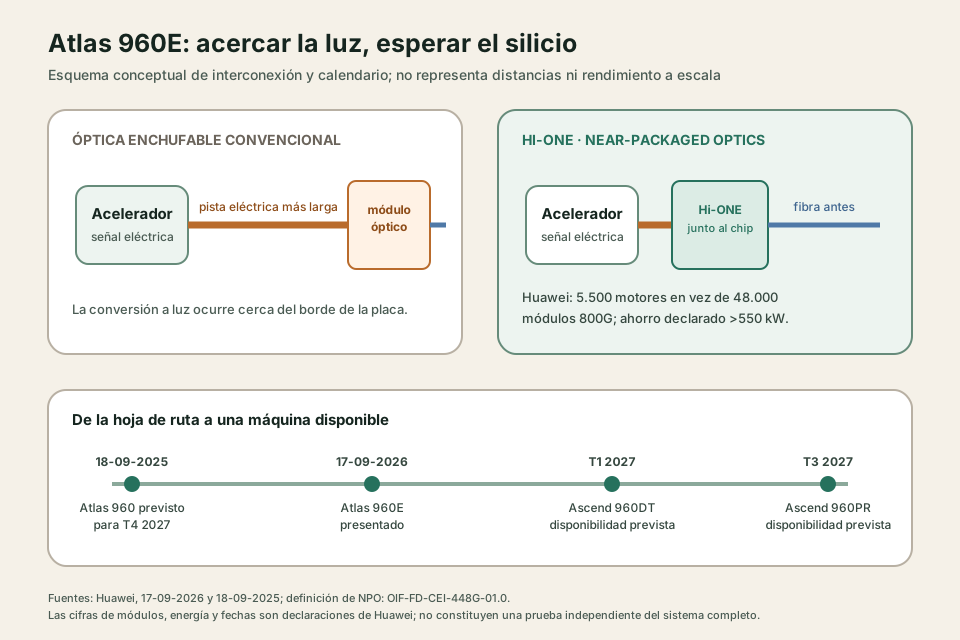
Un 960E nuevo no es todavía el 960 prometido
La comparación con el mapa de ruta que Huawei publicó en septiembre de 2025 evita otra confusión. Entonces anunció un Atlas 960 de 15.488 aceleradores, 30 exaflops FP8 y entrega en el cuarto trimestre de 2027. La presentación de 2026 describe un 960E de 4.096 aceleradores y 8 exaflops FP8. Huawei no dice que el segundo cancele o sustituya al primero, ni explica si será su bloque modular. No son cifras que deban enfrentarse como una rebaja silenciosa.
Lo que sí cambió de forma explícita es la familia de chips. El Ascend 960 genérico previsto para finales de 2027 se divide ahora en un 960DT para entrenamiento y decodificación en el primer trimestre y un 960PR para inferencia en el tercero. Adelantar el primer componente tres trimestres es material, aunque «disponible» todavía necesite un volumen, un precio, servidores compatibles y software capaz de ocuparlo.
Huawei aporta algo de continuidad industrial: afirma que ya ha desplegado más de mil Atlas 900 A3 y que el Atlas 950 ha entrado en uso comercial a gran escala. Un año antes hablaba de más de 300 sistemas A3 en veinte clientes. Esa progresión hace más creíble que el 960E pertenezca a una línea de producto y no sólo a una maqueta. Sigue siendo un recuento del fabricante sin lista de instalaciones, carga sostenida, consumo total ni tasa de utilización publicada.
El anuncio amplía además el dibujo hasta 512.000 aceleradores conectados mediante una red Clos y un millón al añadir varios carriles. Esa cifra describe la capacidad máxima de una topología futura, no una sola memoria coherente ni una máquina construida. Cada nivel añade conmutadores, dominios de fallo y software de planificación. Un millón de dispositivos instalados sería un hito físico; que funcionen como un recurso eficiente es otra afirmación y exige observar utilización, tiempo entre interrupciones y progreso por unidad de energía.
La óptica importa más que el récord de exaflops
Mi lectura es que el Atlas 960E señala una respuesta seria a una restricción que no se resuelve fabricando simplemente un chip mayor. Huawei ya explicó en 2025 que su estrategia, ante el acceso limitado a nodos de fabricación avanzados, consiste en combinar más recursos mediante una arquitectura de sistema propia. Acercar la óptica al procesador convierte esa estrategia en una pieza concreta: intenta pagar menos energía y menos fallos por cada acelerador adicional.
También concentra riesgo. UnifiedBus, los chips Ascend, la memoria, Hi-ONE, la refrigeración líquida y CANN deben madurar juntos. Huawei afirma que ha enviado al OIF una propuesta de acuerdo de implementación para NPO, pero una propuesta no es todavía una especificación adoptada ni garantiza componentes interoperables de otros fabricantes. CANN ha pasado a desarrollo abierto continuo, según la empresa; eso permite inspeccionar más software, aunque no abre el silicio, las mediciones de fiabilidad ni el sistema completo.
La prueba útil de 2027 no será enfrentar el número de NPUs con el de GPUs de otro proveedor. Será ejecutar una carga identificada durante semanas y publicar cuánto de la capacidad pico se convierte en entrenamiento o inferencia útil, con energía de pared, fallos, reparaciones y coste del conjunto. También hará falta distinguir si el ahorro de 550 kilovatios pertenece a un sistema configurado, a una simulación o a una extrapolación del diseño.
Si esas mediciones sostienen las promesas, el cambio práctico sería importante: entrenar y servir modelos grandes con chips fabricables y una red óptica estrechamente integrada ofrecería una ruta adicional para construir infraestructura de frontera. Si no aparecen, Atlas 960E seguirá siendo una buena ilustración de hacia dónde se mueve el cuello de botella. En cualquiera de los dos casos, el anuncio deja una lección menos vistosa que un récord: cuando cuatro mil aceleradores deben actuar como uno, la capacidad del sistema depende tanto de dónde empieza la fibra como de lo rápido que multiplica cada chip.
Fuentes
- Huawei, Huawei Launches the World's First NPO-based SuperPoD – the Atlas 960E SuperPoD, 17 de septiembre de 2026.
- Huawei, Advancing the Agentic World, Building a Solid Silicon Foundation, discurso y preguntas técnicas, 17 de septiembre de 2026.
- Huawei, Groundbreaking SuperPoD Interconnect: Leading a New Paradigm for AI Infrastructure, mapa de ruta publicado el 18 de septiembre de 2025.
- Optical Internetworking Forum, Next Generation CEI-448G Framework, OIF-FD-CEI-448G-01.0, 4 de noviembre de 2025.