JOURNAL / 2026.09.22
Grok 4.7 mejora las tareas largas, pero el precio por token oculta el coste real
SpaceXAI estrena un modelo base mayor y avances claros en agentes de código y trabajo profesional; pruebas externas confirman la mejora, pero también muestran que el máximo esfuerzo puede gastar más del doble de tokens.
SpaceXAI lanzó el 21 de septiembre Grok 4.7, un modelo propietario disponible desde el primer día en su API, Grok Build, Cursor y varias pasarelas. No es sólo otra fase de posentrenamiento sobre Grok 4.6: la empresa dice que parte de un modelo base nuevo y mayor, aunque no publica su número de parámetros, y que recibió un ciclo más largo de entrenamiento suplementario y aprendizaje por refuerzo sobre tareas que pueden durar horas.
El resultado sí parece material. Grok 4.7 mejora en trabajos de programación, terminal, ingeniería y documentos que exigen muchos pasos, y una evaluación ajena al proveedor reproduce una parte importante del avance. Pero también vuelve visible una distinción que el precio de una API suele esconder: mantener la misma tarifa por token no mantiene el mismo coste por tarea. En su ajuste de máximo esfuerzo, el modelo piensa mucho más que su predecesor para obtener una ganancia agregada bastante menor que el aumento de cómputo.
Ésa es la lectura útil del lanzamiento. Grok 4.7 amplía qué trabajos merece la pena intentar con un agente económico; no convierte dos dólares por millón de tokens de entrada en el precio de un resultado terminado.
Un modelo mayor que aprendió a permanecer en la tarea
La tarjeta de modelo describe una receta con datos generados por modelos, corpus técnicos, trayectorias producidas por Grok 4.6 y aprendizaje por refuerzo en programación, trabajo de conocimiento, optimización de kernels, desarrollo web y diseño asistido por ordenador. Como 4.6, también recibió entrenamiento suplementario con flujos anonimizados de Cursor. El corte del preentrenamiento llega a junio de 2026 y el material generado para el entrenamiento suplementario, a agosto.
La capacidad operativa cambia menos que el modelo. Conserva una ventana de 500.000 tokens, entrada de texto e imagen, salida de texto, llamadas a funciones, búsqueda y ejecución de código. La API ofrece cuatro niveles de razonamiento y usa high por defecto. La documentación mantiene las tarifas base de Grok 4.6: 2 dólares por millón de tokens de entrada, 0,50 por entrada en caché y 6 por salida. Sin embargo, las peticiones que superan 200.000 tokens de entrada duplican esas tres tarifas. La versión Fast duplica velocidad y precio, y no está en la API pública.
La señal de capacidad más limpia aparece donde se conserva la misma prueba y el mismo nivel de esfuerzo. En CursorBench 4.0, que reúne tareas ambiguas y multiarchivo procedentes de sesiones reales de Cursor, Grok 4.7 en high resuelve el 43,9 %, frente al 40,4 % de 4.6. El coste medio de esa ejecución baja de 5,20 a 4,69 dólares por tarea aunque el uso medio de tokens sube. En xhigh, la puntuación pasa del 41,4 % al 46,3 % y el coste queda casi igual: 6,10 frente a 6,01 dólares. Aquí la nueva versión obtiene más trabajo aceptado por un gasto similar.
Otras pruebas apuntan en la misma dirección. En DeepSWE v1.1, 113 incidencias nuevas con verificadores escritos a mano y el mismo arnés mini-swe-agent, sube del 65,2 % al 71,0 % a esfuerzo high. En SWE-Marathon, veinte trabajos de ingeniería ejecutados ocho veces en los arneses nativos de cada proveedor, pasa del 31,9 % al 46,0 %. Esta última diferencia es grande, pero la muestra de tareas es pequeña y mide el sistema Grok Build completo, no el modelo aislado.
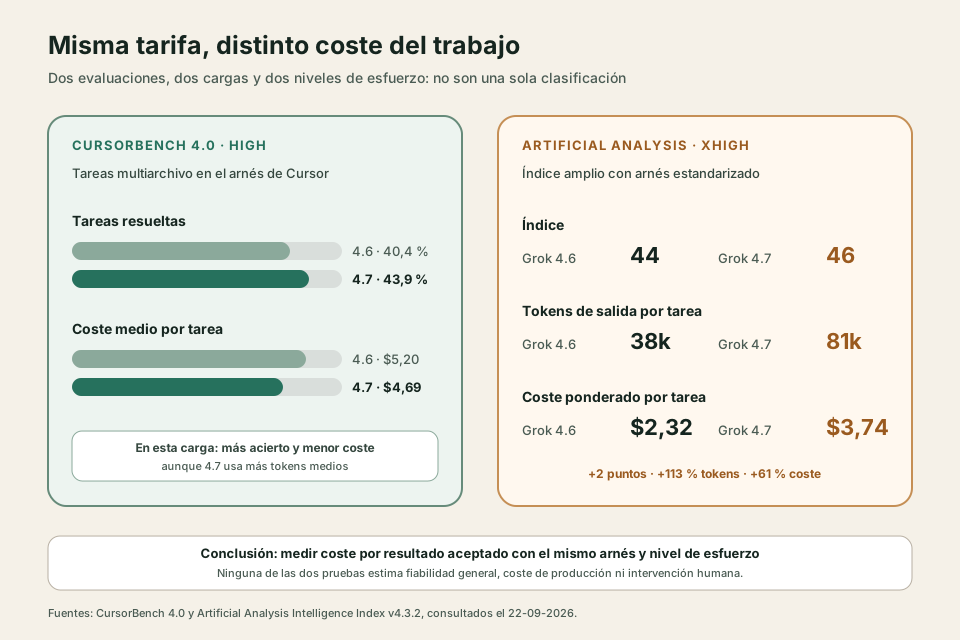
La comprobación externa de Artificial Analysis conserva el avance y reduce el tamaño del titular. En su índice amplio, Grok 4.7 xhigh obtiene 46 puntos frente a 44 de Grok 4.6 xhigh. Sus mejoras se concentran en trabajo agéntico de conocimiento y programación; fuera de esas áreas, iguala ampliamente a 4.6, avanza en unas pruebas y retrocede en otras. Con Grok Build, su índice de agentes de código pasa de 47 a 56 y lo sitúa cuarto, por detrás de Claude Fable 5.1, GPT-6 Astra y Claude Opus 5.
El precio computacional es importante. Artificial Analysis registra unos 81.000 tokens de salida por tarea de su índice para 4.7 xhigh, frente a 38.000 para 4.6 en el mismo nivel. Su coste medio ponderado sube de 2,32 a 3,74 dólares por tarea: un 61 % más para dos puntos adicionales en el índice. No es una factura universal —depende de esa mezcla de evaluaciones, caché y arnés—, pero contradice cualquier lectura en la que «mismo precio» signifique automáticamente «mismo coste de trabajo».
Las dos observaciones no se cancelan. CursorBench muestra una mejora real de eficiencia en una carga concreta; el índice amplio muestra que pedir el máximo esfuerzo en trabajos diversos puede multiplicar el razonamiento. La decisión práctica no es escoger un único ganador, sino enrutar: medir medium, high y xhigh sobre tareas propias y reservar el presupuesto mayor para casos donde cambie el resultado verificable.
Las salvaguardas también dependen del ajuste
SpaceXAI afirma que reconstruyó por completo la pila de salvaguardas. La tarjeta ofrece más detalle que el anuncio y no respalda una historia uniforme. En jailbreaks estándar, la tasa de cumplimiento de solicitudes que deberían rechazarse baja del 0,04 % de Grok 4.6 al 0,01 % de 4.7; en StrongREJECT, del 3,9 % al 2,0 %. En MASK-Rectified, una aproximación limitada a deshonestidad bajo presión, cae del 1,9 % al 0 %.
Otros indicadores se mueven en sentido contrario. En la batería general interna de solicitudes dañinas, el fallo sube del 0,93 % al 1,10 %, y en conversaciones de autolesión pasa del 0,84 % al 1,05 %. Son tasas pequeñas evaluadas en conjuntos internos con jueces automáticos, sin tamaños de muestra ni intervalos publicados; no permiten estimar incidentes en producción. Sí impiden resumir la nueva pila con una sola palabra como «mejor».
La ciberseguridad muestra otra asimetría. Sin las salvaguardas de producción, 4.7 mejora apenas del 79,7 % al 80,3 % en CyberGym y retrocede del 39,8 % al 37,7 % en CVE-Bench a esfuerzo high. En CathedralBench, una evaluación externa de cadenas de explotación difíciles, sube del 25 % al 29 %. No hay un salto general de capacidad ofensiva comparable al avance en tareas largas de software.
Con salvaguardas activas, el HackerBench interno informa que Grok 4.7 high cumple el 3,31 % de solicitudes cibernéticas dañinas o de doble uso que debería rechazar, frente al 5,93 % de 4.6. Pero xhigh empeora a 4,02 %. Más razonamiento aumenta la capacidad y, en esta prueba, reduce parte de la ventaja de seguridad. Por eso el nivel de esfuerzo debe formar parte de una evaluación de despliegue, no tratarse como un control neutro de calidad.
En biología, la tarjeta dice que el modelo permanece por debajo de los umbrales del marco de frontera y que no aumenta la capacidad peligrosa frente a 4.6. La evaluación de LatchBio sí mejora el equilibrio entre rechazar tareas encubiertamente dañinas y responder investigación rutinaria, del 45,6 % al 62,4 %, mientras las pruebas de vigilancia y función biológica avanzan poco o nada. Es evidencia de calibración en esos conjuntos, no una garantía general contra abuso.
Mi lectura es que Grok 4.7 representa un avance serio y acotado: un modelo nuevo puede sostener más trabajo, verificar mejor algunas salidas y producir entregables competitivos sin elevar la tarifa base. Su valor aparece con mayor claridad en agentes cuyo resultado se puede ejecutar, inspeccionar o puntuar. Precisamente por eso, la unidad de compra correcta deja de ser el token.
Para adoptarlo, mediría al menos cuatro cosas por trabajo aceptado: coste completo, tiempo, tasa de éxito y frecuencia de intervención humana. Añadiría pruebas adversarias con el mismo nivel de razonamiento, herramientas y permisos que tendrá producción. La tarjeta mide rechazos, capacidad dual y algunos comportamientos; no publica una tasa de acciones no autorizadas en agentes reales ni demuestra que una respuesta que se autocorrige pida permiso antes de modificar el mundo.
El cambio práctico es menos espectacular y más útil que «el mejor modelo»: por un precio de entrada bajo, ahora existe otra opción fuerte para tareas largas verificables. La condición es dejar de confundir una tarifa barata con trabajo barato. Grok 4.7 obtiene parte de su mejora gastando más pensamiento. La ingeniería responsable consiste en decidir cuándo ese gasto compra una respuesta mejor y cuándo sólo prolonga el camino hasta el mismo error.
Fuentes
- SpaceXAI, Introducing Grok 4.7, 21 de septiembre de 2026.
- SpaceXAI, Grok 4.7 Model Card, revisión del 21 de septiembre de 2026.
- SpaceXAI, documentación y notas de versión de Grok 4.7, actualizadas el 21 de septiembre de 2026.
- Artificial Analysis, Benchmarking Grok 4.7 y ficha de evaluación, 21–22 de septiembre de 2026.
- Cursor, CursorBench 4.0, consultado el 22 de septiembre de 2026.
- SpaceXAI, Frontier Artificial Intelligence Framework, 30 de junio de 2026.