JOURNAL / 2026.09.28
RetroChimera abre la planificación química, pero una ruta aún no es una receta
El modelo combina dos formas de proponer precursores, supera pruebas ciegas con químicos y publica pesos y código; sirve para explorar rutas de síntesis, no para afirmar que una molécula puede fabricarse en el laboratorio.
Para fabricar una molécula no basta con dibujarla. Hay que decidir qué enlaces formar, con qué precursores y en qué orden, hasta llegar a materiales disponibles. La retrosíntesis recorre ese problema al revés: parte del producto deseado y propone desconexiones sucesivas. Una mala reacción en cualquiera de los pasos invalida la ruta completa.
El 21 de septiembre, Nature publicó el artículo revisado por pares sobre RetroChimera, un modelo de Microsoft Research y Novartis que intenta mejorar precisamente esa primera decisión. El trabajo no apareció de la nada: su preprint circula desde diciembre de 2024 y el repositorio abrió una primera versión en 2025. La novedad de esta semana es una combinación más útil que una fecha de portada: el resultado llega al registro de Nature y el repositorio 1.3 publica código de inferencia y entrenamiento y enlaces a los pesos, además de añadir ajuste fino y un modo de consenso bajo licencia MIT.
Eso convierte una afirmación académica en algo que otro equipo puede probar sobre sus moléculas. No convierte la salida en una receta experimental.
Dos modelos discrepan antes de votar
RetroChimera no es un gran modelo de lenguaje conversando sobre química. Combina dos modelos relativamente pequeños que representan el problema de maneras distintas. R-SMILES 2, un Transformer generativo, recibe la molécula objetivo y escribe desde cero cadenas SMILES para posibles reactivos. Puede alejarse de ejemplos conocidos y recuperar transformaciones poco frecuentes, pero esa libertad también le permite inventar estructuras químicamente inverosímiles.
NeuralLoc, una red neuronal de grafos, elige en cambio una plantilla de reacción extraída de los datos y decide en qué átomos aplicarla. Permanece anclada a transformaciones observadas y suele ser más conservadora; a cambio, no puede proponer bien una química ausente de su biblioteca. En el checkpoint principal, el primero tiene 66,7 millones de parámetros y el segundo 165 millones: la ganancia no procede de escalar un único modelo, sino de explotar errores diferentes.
Cada componente entrega una lista ordenada. Una capa de ensamblado aprende cuánto vale el voto de cada modelo en cada posición y suma votos cuando ambos coinciden. Así puede rebajar una propuesta generativa extraña que el modelo de plantillas no reconoce, sin exigir acuerdo absoluto y perder todas las ideas nuevas. El artículo prueba la misma estrategia con otros pares de modelos y encuentra que la diversidad de representación importa más que añadir copias parecidas.
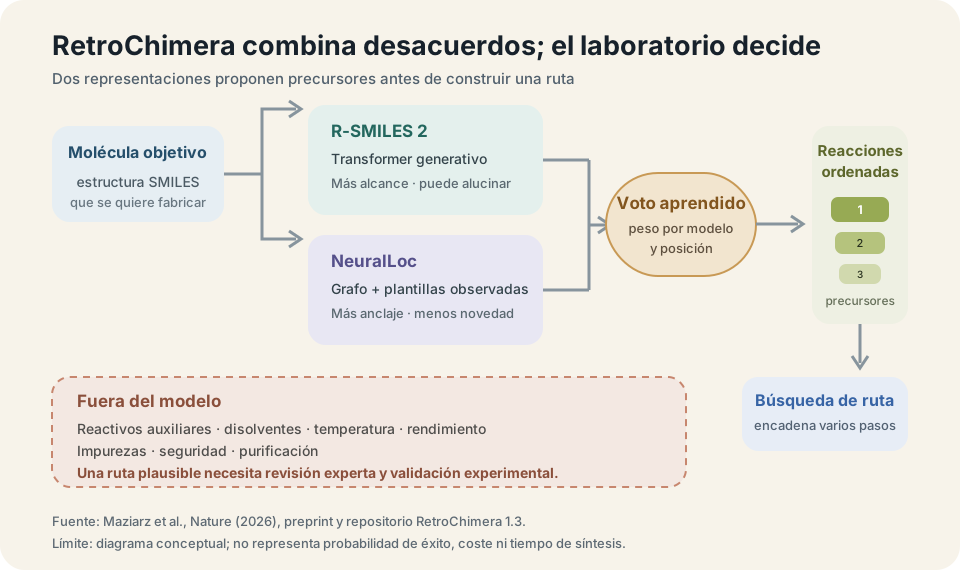
El efecto práctico aparece al buscar más de un paso. En un conjunto de 800 objetivos difíciles, separados del entrenamiento y elegidos porque un sistema anterior no hallaba una ruta corta, RetroChimera resolvió más objetivos que sus componentes cuando la búsqueda tuvo tiempo medio o largo. Aquí «resolver» significa conectar computacionalmente el objetivo con alguno de 23,1 millones de bloques comerciales mediante reacciones propuestas. No significa comprar esos compuestos, ejecutar la secuencia ni obtener el producto.
Los benchmarks públicos también mejoran, pero su lección es acotada. En USPTO-FULL, por ejemplo, la reacción registrada aparece entre las diez primeras propuestas el 79,5 % de las veces, frente al 78,2 % del componente generativo. Esa diferencia mide recuperación dentro de patentes procesadas; no demuestra que la primera ruta elegida sea la más barata, segura o reproducible. El artículo reconoce además que distintas versiones del conjunto USPTO hacen que muchas comparaciones publicadas no sean equivalentes.
La preferencia de un químico no es rendimiento de laboratorio
La evaluación más interesante abandona la coincidencia con una única respuesta histórica. Nueve químicos orgánicos con doctorado —cuatro de Microsoft y cinco de grandes farmacéuticas— realizaron 599 comparaciones a ciegas entre propuestas para la misma molécula. No sabían qué sistema había producido cada reacción y el orden se aleatorizó. Cuando la primera opción de RetroChimera difería de la reacción registrada, los especialistas la prefirieron aproximadamente el 64 % de las veces; el resultado agregado fue estadísticamente significativo.
Es evidencia mejor orientada al uso que contar sólo coincidencias. Una patente conserva lo que alguien hizo, no necesariamente la mejor desconexión posible, y el propio análisis encontró asignaciones estereoquímicas dudosas o reactivos omitidos en los datos. Un modelo puede ser útil precisamente cuando no copia esa referencia.
Pero «preferida» significa que la propuesta parece una mejor decisión sobre el papel. El estudio no pidió a nueve laboratorios que ejecutaran las reacciones. Las comparaciones no se distribuyeron uniformemente, descartaron los casos en que dos fuentes coincidían y no constituyen una réplica multicéntrica independiente: cuatro evaluadores trabajaban en Microsoft y cinco en grandes farmacéuticas. Sirven para demostrar alineación con criterio experto bajo ese protocolo, no una tasa prospectiva de éxito químico.
La frontera aparece con claridad en una nota metodológica: RetroChimera no predice reactivos auxiliares, disolventes ni condiciones de reacción. Tampoco estima rendimiento, impurezas, coste, seguridad o dificultad de purificación. El repositorio recomienda no pedir más de cinco o diez alternativas sin filtros estrictos, usar un modelo adicional de viabilidad y someter cualquier predicción a evaluación química independiente. Incluso así, una comprobación computacional comparte parte de los datos y sesgos del planificador; el experimento sigue siendo el árbitro.
Qué cambia al publicar el planificador
El checkpoint más potente fue entrenado con Pistachio, una base comercial de reacciones disponible hasta 2023. Microsoft libera el modelo resultante y el código, pero no puede convertir ese corpus propietario en un conjunto reproducible. También publica checkpoints más débiles entrenados con datos USPTO y las configuraciones de evaluación. Una prueba adicional sobre 10.444 reacciones internas de Novartis muestra transferencia sin ajuste, aunque los datos cerrados impiden que una tercera parte reconstruya esa comparación.
La apertura sigue siendo material. Un grupo puede ejecutar el modelo localmente, inspeccionar cómo combina las propuestas, integrarlo con Syntheseus y afinarlo con su cuaderno electrónico. Puede además confrontarlo con química posterior a 2023, productos naturales o dominios académicos que los autores señalan como posibles puntos débiles. Es una superficie de investigación, no sólo un endpoint y una gráfica del proveedor.
Mi lectura es que el avance valioso no consiste en reemplazar el juicio del químico, sino en organizar mejor la discrepancia. Un modelo generativo aporta alcance; uno basado en plantillas aporta memoria y restricciones; el voto aprendido decide cuándo confiar en cada uno. Esa arquitectura es menos espectacular que pedir una síntesis a un chatbot, pero se parece más a una herramienta científica: hace visible qué capa propone, cuál filtra y dónde debe intervenir una evidencia distinta.
La siguiente prueba importante debería medir rutas prospectivas completas. Elegir objetivos no presentes en Pistachio, congelar las propuestas antes del experimento y comparar tiempo, coste, rendimiento y número de intentos con planificación humana o con otro sistema. Hasta entonces, RetroChimera ha mejorado y abierto el mapa de posibles caminos. No ha demostrado que el camino elegido pueda recorrerse en el laboratorio.
Fuentes
- Maziarz et al., Chemist-aligned retrosynthesis by ensembling diverse inductive bias models, Nature, 21 de septiembre de 2026; preprint y métodos completos.
- Microsoft Research, Improving synthesis prediction of small molecules at scale with RetroChimera, 21 de septiembre de 2026.
- Microsoft, repositorio, código de entrenamiento, checkpoints y advertencias de RetroChimera, versión 1.3.0.
- Microsoft Foundry, ficha del modelo RetroChimera, consultada el 28 de septiembre de 2026.