JOURNAL / 2026.09.29
Claude Sonnet 5.5 difumina la frontera entre modelo de trabajo y modelo insignia
El nuevo Sonnet se acerca a Opus 5.5 en varias pruebas y reduce tiempo y coste en flujos reales, pero el nivel de esfuerzo y los fallbacks pueden invertir la ventaja que sugiere el precio por token.
Durante años, «Sonnet» quiso decir el Claude práctico y «Opus», el modelo que se reservaba para el trabajo más difícil. Claude Sonnet 5.5, publicado por Anthropic el 28 de septiembre, vuelve menos útil esa jerarquía. En algunas pruebas de programación y trabajo profesional queda muy cerca de Opus 5.5, cuesta la mitad por token y ya está disponible en la API de Claude, AWS, Google Cloud y Microsoft Foundry. No es un anuncio de capacidad futura: es un endpoint que hoy puede reemplazar al Sonnet anterior.
La consecuencia más interesante no cabe, sin embargo, en «casi Opus a precio Sonnet». El modelo ofrece cinco niveles de esfuerzo; la aplicación de Claude usa medium por defecto y la plataforma para desarrolladores, high. Al subir el esfuerzo, el sistema piensa más, usa más tokens y no siempre mejora. Además, ciertas solicitudes activan clasificadores y pueden ser atendidas por Sonnet 5. Elegir claude-sonnet-5-5 ya no identifica por sí solo la capacidad, el coste ni siquiera el modelo que terminará respondiendo.
Anthropic mantiene las tarifas de Sonnet 5: 2 dólares por millón de tokens de entrada, 10 por millón de salida y 0,20 por millón de lecturas de caché. Afirma que la nueva versión genera más de un 30 % deprisa y cuesta hasta un 30 % menos por tarea porque necesita menos pasos. Hay evidencia externa de que esa eficiencia es real en algunos trabajos. También hay evidencia de que desaparece al llevar el dial al máximo.
Una mejora real, no un multiplicador universal
El salto más llamativo de la tabla de Anthropic está en Terminal-Bench 4.0: 70,6 % para Sonnet 5.5 frente a 10,3 % para Sonnet 5. La prueba contiene 66 tareas en terminal, muchas de ingeniería y ciencia, y el resultado nuevo promedia cinco intentos por tarea con Claude Code y esfuerzo máximo. Opus 5.5 obtiene 66,4 %. Con errores estándar de unos 2,5 puntos para ambos modelos, esa diferencia no basta para afirmar que Sonnet sea mejor que Opus; sí respalda que el fallo extraordinario de su predecesor no define ya a la familia.
La magnitud tampoco debe trasladarse a toda la programación. En FrontierCode, que penaliza cambios innecesarios aunque sean correctos, Sonnet 5.5 obtuvo 52,1 % con esfuerzo xhigh y sólo 46,2 % con max. La ficha técnica atribuye parte de la caída a que, en el ajuste máximo, el agente lanzó revisiones adicionales que agotaron el tiempo o ampliaron el cambio fuera de alcance. Más cómputo de inferencia produjo más actividad, no más valor para el criterio medido.
Una evaluación de CodeRabbit sobre revisiones de código reales ayuda a salir del benchmark del proveedor. En 13 pull requests difíciles con un error conocido, Sonnet 5.5 encontró seis mediante comentarios accionables y Sonnet 5 encontró cuatro, con una precisión parecida. La llamada al modelo costó en promedio 0,47 dólares por revisión, frente a 1,16, y el flujo completo tardó 5:27 en vez de 9:55. En un segundo conjunto de 44 revisiones, el tiempo medio volvió a caer aproximadamente a la mitad, aunque el juicio de calidad aún no estaba terminado. Trece casos orientan; no establecen una tasa general de defectos encontrados.
Artificial Analysis encontró el reverso en su índice amplio. Con esfuerzo máximo, Sonnet 5.5 subió 18 puntos respecto a Sonnet 5 y quedó a dos de Opus 5.5, pero generó unos 193.000 tokens de salida por tarea: el máximo que esa organización ha medido. Su coste ponderado fue de 7,60 dólares por tarea, aproximadamente un 50 % más que el Sonnet anterior. La prueba usó una versión previa al lanzamiento con un fallo de salida estructurada ya corregido, por lo que debe repetirse; aun así, muestra por qué «misma tarifa» no significa «menor factura» sin especificar el esfuerzo y el trabajo.
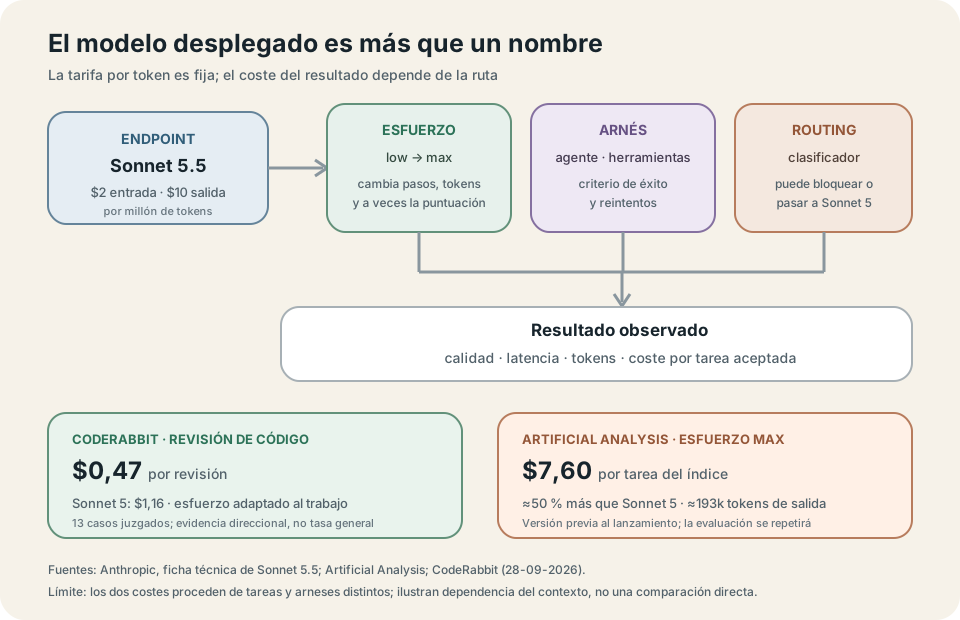
Las dos mediciones no se contradicen. CodeRabbit ajustó low, medium y high a tres clases de revisión y comparó un flujo concreto. Artificial Analysis llevó todos los modelos por una batería común y observó el extremo max. Juntas dicen algo más útil que una clasificación: Sonnet 5.5 puede ser mucho más eficiente que Sonnet 5 cuando el presupuesto de razonamiento se adapta al trabajo, y más caro cuando «máximo» se usa como sustituto de esa decisión.
Un endpoint es también una política de routing
La capacidad cibernética del modelo subió lo suficiente para cambiar el producto. Anthropic dice que sigue por debajo de Opus 5.5 y Mythos 5.1, pero es el primer Sonnet que se publica con sus clasificadores cibernéticos más estrictos. En sus productos propios, y para desarrolladores que aceptan fallbacks en la API, una solicitud de alto riesgo bloqueada pasa visiblemente a Sonnet 5. Otros proveedores pueden aplicar un comportamiento distinto. Los controles de biología bloquean sin un modelo alternativo.
Ese detalle alcanzó las propias cifras de capacidad. En Terminal-Bench, los clasificadores marcaron el 1,2 % de las solicitudes de Sonnet 5.5 y afectaron al 1,5 % de los intentos; el servidor respondió entonces con el modelo de respaldo salvo en un caso. Es una fracción pequeña, pero suficiente para que «puntuación de Sonnet 5.5» describa en realidad un sistema formado por modelo, agente, herramientas, red y router de seguridad. Las evaluaciones de ciberseguridad de la ficha, en cambio, desactivaron esos filtros para medir el modelo subyacente. Ambos resultados son legítimos, pero responden preguntas diferentes.
Mi lectura es que el avance importante no consiste en haber abaratado una inteligencia fija. Anthropic ha acercado mucha capacidad del nivel superior al modelo que puede ejecutarse en volumen, pero ha trasladado más responsabilidad al integrador. La decisión ya no es sólo «Sonnet u Opus»: es qué esfuerzo asignar a cada fase, cuándo escalar a Opus, qué fallbacks acepta el producto y cuánto cuestan los reintentos y la revisión humana.
Eso exige otra unidad de compra. Para una tarea repetida, conviene medir coste por resultado aceptado bajo el mismo arnés: incluir tokens, caché, herramientas, fallos, latencia y tiempo de revisión. También conviene registrar el nivel de esfuerzo y el modelo que respondió realmente. El precio por millón de tokens sigue siendo necesario para facturar; por sí solo se ha vuelto una descripción pobre de lo que se está comprando.
Sonnet 5.5 parece un buen modelo de trabajo precisamente porque no obliga a pagar siempre por su techo. Pero la ventaja existe sólo si el sistema sabe cuándo dejar de pensar. En esta generación, usar bien un modelo importa casi tanto como escogerlo.
Fuentes
- Anthropic, Claude Sonnet 5.5, 28 de septiembre de 2026.
- Anthropic, Claude Sonnet 5.5 System Card, septiembre de 2026.
- Anthropic, documentación del modelo Claude Sonnet 5.5, consultada el 29 de septiembre de 2026.
- Artificial Analysis, Claude Sonnet 5.5 reaches #2 on the Artificial Analysis Intelligence Index, 28 de septiembre de 2026.
- CodeRabbit, Claude Sonnet 5.5 for code review: More catches than Sonnet 5, in half the time, 28 de septiembre de 2026.