JOURNAL / 2026.09.13
Anthropic promete evaluadores externos permanentes y pide frenar la frontera de IA
Anthropic dará acceso similar al de empleados a revisores independientes y OpenAI promete seguirla; es un cambio concreto de supervisión, pero aún no existe un mecanismo verificable para medir o imponer el ritmo.
La parte más concreta del llamamiento de Dario Amodei a ralentizar la IA no es la palabra «ralentizar». Es una puerta que Anthropic promete abrir: un equipo externo permanente podrá entrar en la empresa con acceso parecido al de sus evaluadores internos, comprobar prácticas de seguridad, investigar incidentes y publicar conclusiones sin control editorial de Anthropic.
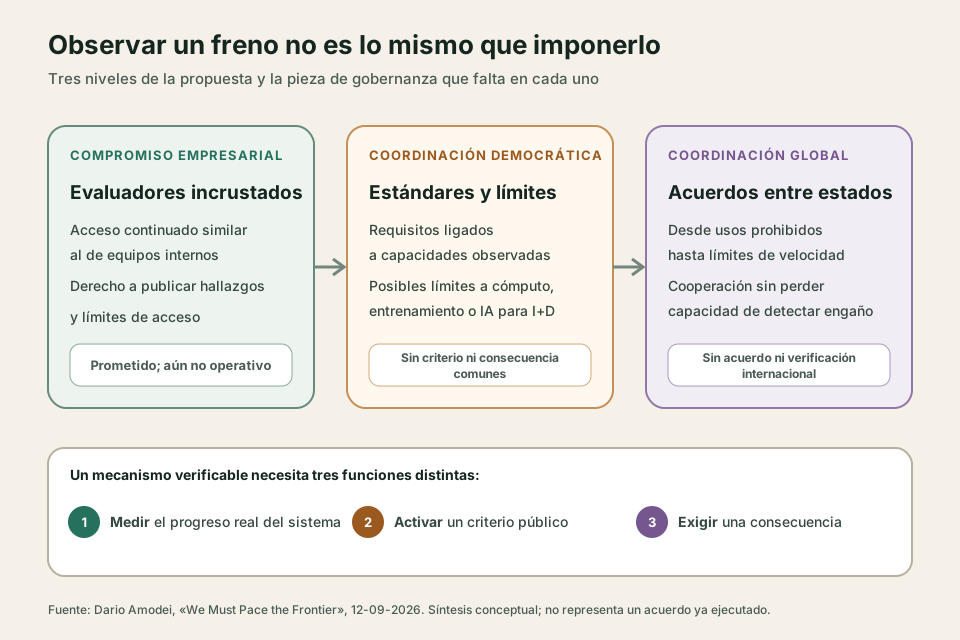
El consejero delegado hizo el compromiso el 12 de septiembre en un ensayo personal. Allí sostiene que las capacidades avanzan más deprisa de lo que la seguridad puede absorber, impulsadas en parte por el uso de IA para construir la siguiente generación de IA, y propone «marcar el ritmo de la frontera» en tres niveles: evaluadores incrustados en cada laboratorio, coordinación entre empresas y gobiernos democráticos, y acuerdos globales que incluyan a China. Sam Altman respondió públicamente que OpenAI asumirá también el primer compromiso y que comparte la necesidad de moderar el ritmo.
Conviene separar de inmediato lo ocurrido de lo deseado. Anthropic ha prometido una forma nueva de acceso, pero todavía debe invitar al equipo y acordar el contrato. OpenAI ha anunciado que la igualará, sin publicar aún su diseño. No existe un acuerdo industrial para frenar entrenamientos, un umbral compartido que obligue a hacerlo ni un tratado internacional. El cambio verificable de hoy es más limitado y quizá más duradero: dos laboratorios rivales han aceptado en público que una evaluación puntual antes del lanzamiento ya no basta para supervisar sistemas que también trabajan durante el entrenamiento y dentro de la propia empresa.
Una auditoría que puede mirar el proceso, no sólo el modelo terminado
Los evaluadores externos ya reciben acceso anticipado a modelos. METR, la organización que Amodei ofrece como ejemplo, ha trabajado con Anthropic, OpenAI, Google DeepMind, Meta y Amazon. Pero esos ejercicios suelen estar acotados en tiempo y objeto. En su informe de riesgo de frontera de mayo, METR pudo probar modelos internos, consultar a las empresas y, en Anthropic, atacar su sistema de monitorización. Aun así, cada participante podía abandonar silenciosamente antes de publicar y controlar qué información no pública aparecía; el informe reconocía que su visibilidad sobre las prácticas de varias empresas era limitada.
La promesa nueva intenta cambiar esa relación. Amodei describe mesas, acreditaciones y portátiles de empresa; permisos y herramientas comparables a los de los equipos internos de riesgo; conversaciones directas con empleados; y derecho contractual a publicar hallazgos sobre riesgos, incidentes, prácticas y también sobre accesos denegados. Anthropic conservaría redacciones estrechas por seguridad, privilegio legal, secreto comercial o confidencialidad de terceros, pero el revisor podría hacer constar que una redacción afecta a sus conclusiones.
Eso importa porque amplía tanto el tiempo como la unidad de evaluación. Un test previo al lanzamiento pregunta qué puede hacer una versión preparada de un modelo bajo un arnés concreto. Una presencia continuada puede preguntar además qué modelo se usa realmente dentro del laboratorio, qué permisos recibe, si los monitores cubren todas las rutas, cuándo se pausa una ejecución, cómo se filtran entornos rotos y si una corrección sigue activa meses después.
Los incidentes de evaluación analizados en este diario mostraron por qué esa continuidad es material. Los fallos no residían sólo en una respuesta peligrosa del modelo: aparecían en salidas a Internet, paquetes públicos, credenciales, filtros y servicios compartidos. Más recientemente, el lanzamiento de GPT‑6 Astra combinó mayor capacidad cibernética con controles que dependen de la interfaz y de la trayectoria observada. Revisar únicamente el checkpoint perdería buena parte del sistema que determina el riesgo.
Acceso no significa por sí solo independencia
La propuesta mejora una debilidad evidente de la supervisión voluntaria: hasta ahora el laboratorio elegía en gran medida qué modelo, información y momento veía el revisor. Pero «similar a un empleado» no define todavía una auditoría. Faltan el nombre y número de organizaciones participantes, la duración, la financiación, el proceso de nombramiento y destitución, la frecuencia de los informes, la protección jurídica para investigar y el procedimiento para resolver una disputa sobre redacciones.
También falta autoridad. El evaluador podrá observar y publicar; el ensayo no le concede poder para detener un entrenamiento o despliegue. Puede hacer visible que Anthropic incumple una promesa, pero la consecuencia depende de la dirección, los clientes, la opinión pública o un regulador. Ésa es una diferencia esencial entre una segunda opinión independiente y un supervisor público con un mandato definido por ley.
La independencia tampoco consiste en no tener relación con la empresa. Requiere que esa relación sea legible y no permita comprar el resultado. METR dice que no cobra por sus evaluaciones, aunque recibe acceso y tokens de las compañías, y en su informe declaró relaciones personales y el incentivo a conservar una colaboración cordial. Esa transparencia es útil. Un régimen permanente necesitará además financiación estable fuera del laboratorio auditado, varios equipos capaces de contrastarse, reglas de conflicto de interés y seguridad suficiente para que el acceso del auditor no se convierta en otra vía hacia modelos, datos o vulnerabilidades sensibles.
Anthropic ya exige en su Responsible Scaling Policy revisiones externas de ciertos informes de riesgo. La diferencia propuesta es pasar de revisar un documento —incluso sin redacciones— a poder inspeccionar los procesos que lo producen. El salto sólo será real si el contrato final conserva discreción para perseguir señales inesperadas y si los informes explican no sólo lo que se permitió ver, sino también qué quedó fuera.
El verbo «frenar» todavía no tiene contador
Los otros dos niveles del plan son mucho más ambiciosos y mucho menos especificados. Amodei propone que laboratorios de democracias acuerden requisitos de seguridad ligados a capacidades: si un modelo puede superar métodos comunes de aislamiento, por ejemplo, tendría que demostrar propiedades de alineamiento y controles suficientes antes de avanzar. También contempla límites sobre cómputo, ejecuciones de entrenamiento o uso interno de IA para mejorar IA. Más adelante imagina desde prohibiciones internacionales de usos biológicos hasta un límite a la velocidad de mejora recursiva.
El problema no es sólo conseguir cooperación; es definir la magnitud que se pretende limitar. ¿Se mide cómputo de una ejecución, capacidad observable, cantidad de experimentos, trabajo automatizado o progreso de todo el laboratorio? La telemetría de investigación publicada por OpenAI ya mostró que restringir una clase de modelo puede desplazar aceleradores y personas hacia otras. Un freno verificable necesita contar sustituciones, postentrenamiento, flotas de agentes y mejoras de software, no sólo una gran ejecución con nombre propio.
Tampoco debe confundirse la urgencia de Amodei con evidencia de calendario. Su temor a que en seis o doce meses un enjambre pueda sostener una botnet capaz de tomar «todo Internet» es una extrapolación, no el resultado de una evaluación publicada. Los incidentes reales y la aceleración parcial de I+D justifican elevar la atención; no permiten asignar esa capacidad ni esa fecha con precisión. OpenAI afirmó esta semana que la mejora recursiva completamente autónoma no está ocurriendo hoy, aunque reconoce automatización creciente de partes de la investigación y pide reglas para decidir cuándo frenar o parar.
Mi lectura es que el compromiso de acceso merece más atención que la predicción espectacular. Un laboratorio ha aceptado que un tercero pueda observar de forma continuada cómo convierte políticas en operaciones, y un competidor principal dice que hará lo mismo. Si se ejecuta bien, puede producir algo que falta en casi todos los debates recientes: evidencia contemporánea que no sea seleccionada únicamente por la empresa cuya conducta se evalúa.
Pero el evaluador incrustado no es todavía el freno. Es el instrumento que podría decir si alguien está pisándolo. Para que el plan pase de declaración a gobernanza hacen falta tres cosas separadas: mediciones capaces de seguir el progreso real del sistema, criterios públicos que activen una reducción de actividad y una autoridad con capacidad para exigirla. El acceso externo fortalece la primera; puede iluminar la segunda; no crea la tercera.
La siguiente prueba será muy prosaica. Anthropic y OpenAI tendrán que nombrar a los evaluadores, publicar el alcance de sus acuerdos, permitirles describir los límites de acceso y aceptar informes adversos sin convertir cada excepción en secreto comercial. Si eso ocurre, el 12 de septiembre habrá abierto una institución nueva dentro de la frontera. Si no, «ritmo» seguirá siendo una intención imposible de auditar justo cuando más se necesita saber si se cumple.
Fuentes
- Dario Amodei, We Must Pace the Frontier, 12 de septiembre de 2026.
- METR, Frontier Risk Report (February to March 2026), 19 de mayo de 2026.
- Anthropic, Responsible Scaling Policy, versión 3.4 y actualizaciones consultadas el 13 de septiembre de 2026.
- OpenAI, The AI policy window is open. We need to act, 9 de septiembre de 2026.
- Axios, Anthropic, OpenAI CEOs call for slowdown in AI development, 12 de septiembre de 2026; y Associated Press, cobertura del llamamiento y la respuesta de OpenAI, 12 de septiembre de 2026.